ラベル couchdb の投稿を表示しています。 すべての投稿を表示

2012/05/05

Debian WheezyでCouchDB 1.2.0をコンパイルした時にはまった事

CouchDB 1.2.0をさくらVPSで稼働しているDebian wheezyに導入したのですが、 エラーがでてcouchjsが実行できない自体になった時のトラブルシュートのログです。

エラーの内容

couchdb自体は問題なく起動したものの、viewを参照するとvar/log/couchdb/couch.logに次のようなエラーが大量に書き込まれていました。

...
[Wed, 02 May 2012 06:30:37 GMT] [error] [<0.4852.0>] OS Process Error <0.5474.0> :: {os_process_error,
                                                     {exit_status,139}}
[Wed, 02 May 2012 06:30:37 GMT] [error] [<0.4852.0>] OS Process Error <0.5477.0> :: {os_process_error,
                                                     {exit_status,139}}
...

原因はSpiderMonkeyのライブラリバージョンにあったのですが、 突き止めるまでに時間が少しかかってしまいました。

Debian wheezyで利用可能なSpiderMonkeyのバージョン

このバージョンのDebianでは2種類のライブラリが使用可能です。

  • libmozjs-dev - Development files for the Mozilla SpiderMonkey JavaScript library
  • libmozjs10d - Mozilla SpiderMonkey JavaScript library
  • libmozjs185-1.0 - Spidermonkey javascript engine
  • libmozjs185-dev - Spidermonkey javascript library - development headers

先頭2つのlibmozjs-devとlibmozjs10dはDebianプロジェクトが開発するfirefox互換ブラウザに組み込まれているJavaScriptエンジンで基本的にはSpiderMonkeyと同一ですが、Mozillaプロジェクトが配布しているSpiderMonkeyのバージョンは1.8.xとなっています。

このライブラリを導入した状態でCouchDBのconfigureを走らせると、バージョンが新し過ぎてサポートされていない旨が表示されます。

そこでlibmozjs185-1.0とlibmozjs185-devを導入して、configureが問題なく動くようにしたのですが、これが問題を引き起した原因となりました。

configureの振舞い

先ほどリストした全てのパッケージが入った状態では、configureは問題なく完了します。

この状態ではcouchjsコマンドだけが、libmozjsとリンクされてしまいます。 正しいのはlibmozj185とリンクされている状態ですが、lddでみるとlibmozjs10dパッケージに含まれるライブラリとリンクされています。

$ ldd src/couchdb/priv/couchjs |grep js
	libmozjs.so.10d => /usr/lib/libmozjs.so.10d (0x00007fab300d0000)

まぁconfigureのバグなんですが、このお陰でviewにアクセスした時だけ結果が正しく帰ってこない事になります。

couchjsコマンドのデバッグ方法

で、原因を突き止めるために、簡単なJavaScriptで書かれたスクリプト(a.js)を準備して実行してみます。

a.jsスクリプトファイル

print("test");
 $ /usr/local/bin/couchjs a.js
Segmentation fault

どこで落ちたのか原因を探るためにstraceを使う事が多いのですが、今回はまったく役に立ちませんでした。

結局のところgdbを使ってlibmozjs.soライブラリの中で落ちている事を確認しました。

 $ gdb /usr/local/bin/couchjs
 (gdb) run a.js
 (gdb) backtrace
(gdb) backtrace 
#0  0x00000000004049e5 in ?? ()
#1  0x00007ffff76d5ab8 in ?? () from /usr/lib/libmozjs.so.10d
#2  0x00007ffff764c937 in JS_ExecuteScript () from /usr/lib/libmozjs.so.10d
#3  0x000000000040227c in main (argc=<optimized out>, argv=<optimized out>)
    at couch_js/sm185.c:389

これで無事に/usr/lib/libmozjs.so.10dの中の処理で落ちていて、本来リンクして欲しくないライブラリを参照していた事が原因だとわかりました。

回避策

この問題を避けるためには、毎回正しいlibmozjs関連のファイルをポイントするようにconfigureオプションを指定する他ありません。

幸い、couchdb 1.2.0もdebian wheezyも比較的新しいパッケージなので、昔のcouchdbのようにinclude fileから指定する必要はなくなっています。

configureを次のように実行して、libmozjs185.soをリンクしている事を確認します。

./configure --with-js-lib-name=mozjs185
checking for JS185... yes
checking jsapi.h usability... yes
checking jsapi.h presence... yes
checking for jsapi.h... yes
checking for JS_NewObject in -lmozjs185... yes

これでlibmozjs10dパッケージが導入されていても、エラーなくcouchdbが動きます。

さいごに

configureの中でヘッダーファイルのチェックでpkg-configを使っているのに、ライブラリのチェックでは実際にコンパイルできるか普通にチェックしてしまっているので、libmozjs.so.10dをリンクしてしまっていました。

これはバグだとは思うのですが、pkg-configにlibmoz185パッケージが入っているとは限りませんし、どちらもECMAScript Ver.5をサポートするようにできているので、関数のチェックを確実に行なうのは難しそうに思えます。

CouchDBの経験があればcouchjsが動かないだけで、libmozjs周りを見に行くとは思うのですが、今回は現象だけをみても原因がよく分からなかったために時間を数時間ロスしてしまいました。

まだtestingフェーズのdebian wheezyを使っている人が多いとは思いませんし、そんな人達は自力で解決しちゃうと思いますが、どなたかの役に立てば幸いです。

2012/05/02

さくらVPSのDebian wheezyにCouchDB 1.2.0をインストールしてみた

少し時間ができたのでCouchDB 1.0の環境を1.2にアップグレードする事にしました。

手製ツールの稼働検証やら、DTIのVPSに作った郵便番号検索の仕組みを更新するとか、1.0から1.2への変化をキャッチアップするだけで、何だかぐったりするような作業で腰が重かったのですが、この機会に(現実逃避を兼ねて)とりかかることにしました。

私のcouchdbの使い方はバックエンドサーバーとして使うものなので、フロントエンドにcouchdbを使おうとする普通の使い方をする方はSSLなどのセキュリティ設定にもっと注力する必要がある事に

進め方の方針

アップグレードとはいっても現状の環境は止めるわけにいかないので、さくらのVPSに構築したtestingステータスのDebian wheezy上に新規にEarlang, CouchDB、その他の自前ツール等々をインストールをして、切り替えることにしました。

最終的にはCNAMEで設定しているwww.yadiary.netのレコードを書き換える事で対応する予定です。

対象の環境

現行のDTIのプランは490円のCPU: shared 1core, Memory: 256MB (max. 1GB)の構成で、 スペックをみる限りはリッチですが、このアプリケーションの性能にはほとんど変化ないだろうと考えています。

さくらVPSに構築しようとしている環境は次の通りです。

  • VPSプラン: さくらのVPS 2G (CPU: shared 3core, Memory: 2GB)
  • OS: Debian wheezy (次期stable、現testing), 64bit (x86_64)
  • Earlang: OTP-R15B01
  • CouchDB: 1.2.0

ちなみにDTIにある現行機は、Debian squeezeで、Earlang/OTP-R14B, CouchDB-1.0.2という構成です。

CouchDB 1.0系と1.2系の違いについて

1.1での変更も含めた完全なリストは apache-couchdb-1.2.0.tar.gz に含まれるCHANGESファイルにあります。

Native SSLサポートが含まれていたり、細かい点ではセキュリティ上の改善点もいくつか含まれています。

インストール手順

基本的な進め方はCouchDB: 1.0.1から1.0.2のリリースアップ手順 (xstow対応版)に従って進めていきます。

バージョンアップする時には/usr/local/etc以下に配置してある設定ファイルを退避して、新しいバージョンの設定ファイルをコピー、編集する事になりますが、1.2.0でも進め方に違いはありませんでした。

今回もxstowを使って/usr/local以下にインストールするため、/usr/local/stow以下にインストールしたcouchdb-1.2.0の直下からvarディレクトリは/usr/local/var以下に移動しています。 さらにスクリプトファイルから/usr/local/stow/couchdb-1.2.0/varを参照している個所を修正します。

確認するべき対象は次のコマンドで確認しました。

$ find . -type f | while read file ; do grep 1.2.0/var $file > /dev/null 2>&1 && echo $file ;  done

以前はetcファイルも/usr/local/etcに直接展開していましたが、今回は止めました。 バージョンアップの頻度は思ったよりも多くはなくて、その度にlocal.iniをコピーしても手間ではなさそうですから。

VPSサーバでの稼働検証

普通にサーバーを立ち上げるとIPv4のloopbackアドレス(127.0.0.1)にバインドします。 手元にないサーバーへ接続する場合に、グローバルアドレスにいきなりバインドすると外部に対して無防備になってしまいます。

一般的にサービス前のサーバーに接続するために、いくつかの方法が考えられます。

稼働確認という意味では、sshが一番簡単だろうと思います。 サービスイン後も使い続けるのであれば、stunnelがお勧めです。

ただWebサーバーのVirtualHostや、SSLポートのように、アクセス時に指定するサーバー名も重要な要素となる場合には、そうも簡単にはいきません。 今後のためにはiptablesを使った方法も、見当しておく必要があります。

というわけで、今回はiptables/ip6tablesを使ってグローバルアドレスにバインドさせてみる事にします。

iptablesを使った接続制御

iptables/ip6tablesを使う場合には、既にあるルールを汚染せずに追加、削除を行なう必要があります。 ここではポート番号を5985にして、このポート番号に対する制御は事前にされていない前提で作業を行ないます。

local.iniファイルの編集

IPv6アドレスを使っていますが、IPv4アドレスを使う場合には、アドレスの他にip6tablesをiptablesに読み替えてください。

/usr/local/etc/couchdb/local.iniファイルの編集個所

port = 5985
bind_address = 2001:xxxx:31d5:87d3::1
サーバー起動前:iptablesへのルール追加

デフォルトのINPUTルールが、ACCEPTでなければ2行目は不要ですが、明示的に1行目で指定した以外のIPv6アドレスからの接続を拒否しています。

 $ sudo ip6tables -A INPUT -p tcp --dport 5985 -s 2001:3e0:a32:xxxx:8d45:678a:2fe8:xxxx -j ACCEPT
 $ sudo ip6tables -A INPUT -p tcp --dport 5985 -j DROP 

稼働確認

サーバー上の設定が反映されている事を確認します。

 $ sudo ip6tables -L
Chain INPUT (policy ACCEPT)
target     prot opt source               destination         
ACCEPT     tcp      2001:3e0:a31:1:7d44:6780:2fd9:ca43/128  anywhere             tcp dpt:5985
DROP       tcp      anywhere             anywhere             tcp dpt:5985

設定が反映されていれば、サーバーを起動します。

 $ sudo /usr/local/etc/init.d/couchdb start

これでWebサーバからアクセスする事ができます。 IPv6アドレスを使う場合にはURLが http://[2001:3e0:a32:xxxx:8d45:678a:2fe8:xxxx]:5985/_utils/のように[]で囲む点に注意が必要です。

で、いろいろ作業が終ったらサーバを停止しておきます。

 $ sudo /usr/local/etc/init.d/couchdb stop
サーバー停止後:iptablesルールの削除

偶然サーバーが起動してしまう可能性もありますが、将来的にこの方法を使う事はないので、ip6tablesルールを削除しておきます。

 $ sudo ip6tables -D INPUT -p tcp --dport 5985 -s 2001:3e0:a32:xxxx:8d45:678a:2fe8:xxxx -j ACCEPT
 $ sudo ip6tables -D INPUT -p tcp --dport 5985 -j DROP

作業が終ったところで、 $ sudo ip6tables -L で追加したルールが残っていない事を確認します。

まとめ

とりあえず、これで動くところまでは確認できました。 ここからはいままで作ってきたパッチを1.2に対応させていきます。

参考文献

CouchDBについては公式Webサイトは宣伝要素が強いので、CouchDB Wikiがより実践的で、役に立つと思います。

2011/03/04

YALTools: 手作業によるデータベースコピーの効率

CouchDBをメンテナンスするために作成したlscouchdbのパフォーマンスを考えてみました。

対象はDTI VPSにホスティングしているサーバー上のCouchDB 1.0.2です。

lscouchdbをコピーしてloopbackのCouchDBのポートに直接接続しているので、計測したデータの大部分はサーバのCPUとDisk I/Oのパフォーマンスに依存しています。

テストの概要

次のようなイディオムを使って、郵便番号DBに入っているView定義によるインデックス分を除く全データ(約220MB、約12万件)のコピーを作成しています。

作業手順

$ sbin/mkdb testp
$ time bin/lsdocs postal -u 15 | grep -v "_design/" | bin/postdocs -u 15 testp
$ sbin/rmdb testp

何回か-u 15の数字を増やして様子をみてみます。

PhenomII X4 940 (Mem: 8GB)での結果

物理メモリの半分ほどはファイルキャッシュに使われていて、今回のデータは十分この範囲に収まるようになっています。手元のPCを使った場合の結果は次のようになりました。

PhenomII X4 940での挙動: time bin/lsdocs postal -u 200 | grep -v _design | bin/postdocs testp -u 200


real	18m13.589s
user	1m3.160s
sys	0m8.400s

PhenomII X4 940での挙動: $ time bin/lsdocs postal -u 200 | grep -v _design | bin/postdocs testp -u 50


real	17m43.949s
user	1m7.320s
sys	0m8.520s

PhenomII X4 940での挙動: $ time bin/lsdocs postal -u 50 | grep -v _design | bin/postdocs testp -u 200


real	61m45.391s
user	1m12.870s
sys	0m12.770s

読み出し単位を4倍にして時間が1/4になっているので、読み出し回数は低く抑える方が良さそうです。

ちなみにDTI@VPSのエントリーレベル(256MB)で実行すると次のようになります。 Muninで観察している範囲では使用メモリは、この時間帯は180-190MBの範囲で遷移していました。

DTI@VPSでの挙動: time bin/lsdocs postal -u 220 | grep -v _design | bin/postdocs testp -u 100


real	22m51.496s
user	0m46.429s
sys	0m4.081s

ポイントは読み込み処理の効率化らしい

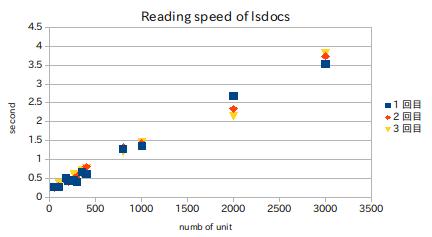
結局のところはデータを保存するパフォーマンスよりも、読み出しの単位を効率的なところにおさめるのが必要そうです。PhenomII X4 940 8GBで、データを取ってみました。

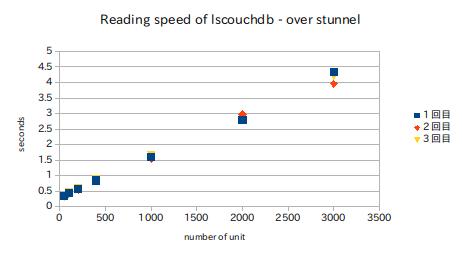
50〜3000件を一度に取得するようなコマンドラインの実行時間をtimeコマンドで取って、real時間をグラフにしてみました。

データ取得用のコマンドライン

$ i=50; time bin/lsdocs postal -u $i -p 1 > /dev/null

横軸がunitで、縦軸に処理時間をとったグラフ

/_all_docsの効率的な数字は環境によるはずですが、1秒辺りの処理件数は2000件で最高の836件になったので、2000前後にしておくのが良さそうです。

ここら辺を踏まえつつ、どうせ読み込み時間が線形に伸びるなら大きな数字にしてしまえと、やった結果が次のようになりました。

PhenomII X4 940での挙動: $ time bin/lsdocs postal -u 2000 | grep -v _design | bin/postdocs testp -u 200


real	5m4.372s
user	0m59.750s
sys	0m6.710s

書き込みの単位を増やしても、ほとんど影響がみられませんでした。

PhenomII X4 940での挙動: $ time bin/lsdocs postal -u 2000 | grep -v _design | bin/postdocs testp -u 2000


real	4m57.758s
user	0m54.100s
sys	0m6.500s

Proxy的な中間層がある場合の処理

注意しなければならないのは、今回の作業はバックエンドに直接接続しているということです。

これがstunnelなどを介している場合には、中間層のオーバーヘッドが問題になって時には処理が滞留することもあります。

Stunnelを使用した時の読み込み速度

読み出し側はだいたい10%程度のパフォーマンスダウンですが、書き込み時の単位を50件にすると処理は進みません。

手元の環境では25程度の書き込みにしないとCouchDBへの書き込みが発生しませんでした。

PhenomII X4 940での挙動:$ time bin/lsdocs postal -u 2000 -x stunnel.admin | grep -v _design | bin/postdocs testp -u 25 -x stunnel.admin


real	12m5.389s
user	1m36.620s
sys	0m7.260s

2011/02/02

CouchDB: 1.0.1から1.0.2のリリースアップ手順 (xstow対応版)

家にあるalixやらworkstationやらhttp://www.yadiary.net/にあるソフトウェアのバージョン管理にはxstowを利用しています。

最初にコンパイルしたapache couchdb version 1.0.1は/usr/local/stow/couchdb-1.0.1をconfigureの'--prefix'に指定しています。

今回は始めてのバージョンアップになります。

まぁstowのマニュアルには/usr/localをprefixに指定して、make install時に変数を上書きするような方法をとるわけですが、そうすると間違って/usr/local/stow以下でコマンドを実行しても、それなりに動いてしまうのが痛いところなわけです。

さて、今回はapache-couchdb-1.0.2がリリースされてしばらく経ち、いろいろテストしてみてもそのまま移行して問題なさそうな感じなので、その作業をまとめたログです。

現行環境の確認

インストールする環境はDTIのVPSで使っているDebian squeezeです。

stowディレクトリの構造

local.iniなどはバージョンに対して不変なので、stowディレクトリには含めていません。

深さ2ぐらいまでのディレクトリ構造は次のようになっています。

$ find /usr/local/stow/couchdb-1.0.1 -maxdepth 2
/usr/local/stow/couchdb-1.0.1/etc
/usr/local/stow/couchdb-1.0.1/etc/init.d
/usr/local/stow/couchdb-1.0.1/etc/logrotate.d
/usr/local/stow/couchdb-1.0.1/share
/usr/local/stow/couchdb-1.0.1/share/man
/usr/local/stow/couchdb-1.0.1/share/couchdb
/usr/local/stow/couchdb-1.0.1/share/doc
/usr/local/stow/couchdb-1.0.1/bin
/usr/local/stow/couchdb-1.0.1/bin/couchdb
/usr/local/stow/couchdb-1.0.1/bin/couchjs
/usr/local/stow/couchdb-1.0.1/lib
/usr/local/stow/couchdb-1.0.1/lib/couchdb
テスト環境で発見した不具合

このままstow側にないディレクトリ(例: var/, etc/couchdb)を同じように削除して、バージョンアップすると、ちょっとした問題が発生しました。

stowに含めないファイルはバージョンに依存しない情報を持っている事が前提だったのですが、default.iniファイルにはいろいろとパス名を含めた情報が記述されています。

$code_cap

...
util_driver_dir = /usr/local/lib/couchdb/erlang/lib/couch-1.0.1/priv/lib
...

このため$ sudo xstow -D couchdb-1.0.1を実行してから、/usr/local/etc/couchdb/default* ファイルたちを /usr/local/stow/couchdb-1.0.1/etc/couchdb 以下に退避してから、$ sudo xstow couchdb-1.0.2を実行する手間がかかっています。

置き換え手前までの作業

今回はノーマルなcouchdb-1.0.2のパッケージに加えて、自作のパッチを適用しています。

準備したファイルは次の通りです。

gropu_numrows関係のファイルは差分ではないので、直接置き換えます。 差分はGitHub上で確認できます。

コンパイルとインストール
$ tar xvzf apache-couchdb-1.0.2.tar.gz
$ mkdir apache-couchdb-1.0.2.extras
$ cd apache-couchdb-1.0.2.extras
$ curl -o couch_db.hrl https://github.com/YasuhiroABE/CouchDB-Group_NumRows/raw/couchdb-1.0.2/couch_db.hrl
$ curl -o couch_httpd_view.erl https://github.com/YasuhiroABE/CouchDB-Group_NumRows/raw/couchdb-1.0.2/couch_httpd_view.erl
$ cp couch_db.hrl couch_httpd_view.erl ../apache-couchdb-1.0.2/src/couchdb/
$ cd ../apache-couchdb-1.0.2
$ ./configure --prefix=/usr/local/stow/couchdb-1.0.2
$ make
$ sudo mkdir /usr/local/stow/couchdb-1.0.2
$ sudo chown $(id -un) /usr/local/stow/couchdb-1.0.2
$ make install
$ sudo chown -R root:couchdb /usr/local/stow/couchdb-1.0.2
stowで管理しない不要なファイル・ディレクトリの削除

インストールまでは、これで終りで次にvarディレクトリなど/usr/local/以下に直接配置するファイルやディレクトリを削除していきます。

新規に導入する場合には、削除ではなくて、対応する/usr/localの場所にmvする事になります。

$ sudo rm -rf /usr/local/stow/couchdb-1.0.2/var
$ sudo rm -rf /usr/local/stow/couchdb-1.0.2/etc/couchdb/local.*
$ sudo rm -rf /usr/local/stow/couchdb-1.0.2/etc/default
埋め込まれた"stow/couchdb-1.0.2/"パスの削除

スクリプトファイルなどの中からstow/を含むパスを通じて参照している部分を書き換えて/usr/local/stowを参照するようにします。

候補は次のコマンドラインで表示されますが、lib/couchdb/以下のファイルは設定ファイルで指定するので作業を行ないません。

ファイルを開いて書き換えますが、viを使った場合のコマンドラインは次のようになります → :%s!stow/couchdb-1.0.2/!!

 $ find /usr/local/stow/couchdb-1.0.2/ -type f | while read file ; do grep stow/ $file > /dev/null 2>&1 && echo $file ;  done
/usr/local/stow/couchdb-1.0.2/etc/init.d/couchdb
/usr/local/stow/couchdb-1.0.2/etc/logrotate.d/couchdb
/usr/local/stow/couchdb-1.0.2/etc/couchdb/default.ini
/usr/local/stow/couchdb-1.0.2/lib/couchdb/erlang/lib/couch-1.0.2/ebin/couch.app
/usr/local/stow/couchdb-1.0.2/lib/couchdb/erlang/lib/couch-1.0.2/priv/lib/couch_icu_driver.la
/usr/local/stow/couchdb-1.0.2/bin/couchjs
/usr/local/stow/couchdb-1.0.2/bin/couchdb

これで準備作業は全て完了しました。

couchdb-1.0.1からのバージョンアップ

最初に説明したように、通常であればcouchdbで停止してxstowコマンドで切り替えるだけなのですが、今回はstowで管理するファイルにdefault.iniとdefault.dを追加したのでxstowでcouchdb-1.0.1のリンクを削除した後で、このファイルを手動で移動する必要があります。

たぶんコマンドラインは次のようになるはずです。

$ cd /usr/local/stow
$ sudo /etc/init.d/couchdb stop
$ ps auxwww|grep couchdb          ## ← eralangプロセス(beam)の停止を確認
$ sudo xstow -D couchdb-1.0.1
$ sudo mkdir couchdb-1.0.1/etc/couchdb
$ sudo mv ../etc/couchdb/default.* couchdb-1.0.1/etc/couchdb
$ sudo xstow couchdb-1.0.2
$ sudo /etc/init.d/couchdb start

とりあえずこの手順通りで無事にhttp://www.yadiary.net/で動いているCouchDBを1.0.1から.1.0.2に移行する事ができました。

2011/01/19

StunnelのクライアントモードでCouchDBに接続する

CouchDB自体には通信を暗号化する機能が1.1系列からしか準備されていないので、stunnelを使っています。

普段は「CouchDB: Ruby CouchモジュールをDigest認証対応にする」ようにSSL接続に対応したクライアントを使っています。

とはいえCouchDB自体には、SSL接続に対応した機能がないので、CouchDB同士を接続する必要があるレプリケーション(Replication)を有効にするためにStunnelのクライアント機能を使ってみました。

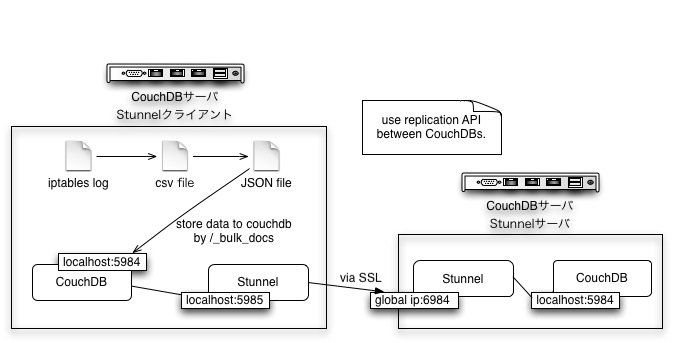
実際にはCouchDBの間にはインターネットがありますが、おおまかなシステム構成図は次のとおりです。

Stunnel Client: System Overview

Stunnelサーバ設定の確認

CouchDBの起動時にdefault/couchdbファイルに書かれているstunnelを起動するコマンドラインは次のようになっています。

/usr/bin/stunnel -v 3 -a /usr/local/etc/couchdb/sslcerts -d :::6984 -r 127.0.0.1:5984

-aオプションに指定しているディレクトリの中は次のような感じです。

$ sudo ls -l /usr/local/etc/couchdb/sslcerts
lrwxrwxrwx 1 root couchdb   17 Dec  2 11:44 22f12cbd.0 -> demoCA.cacert.pem
lrwxrwxrwx 1 root couchdb   23 Dec  2 11:44 6b0ab199.0 -> stunnel.client.cert.pem
-rw-r----- 1 root root    3664 Dec  2 10:23 demoCA.cacert.pem
-rw-r--r-- 1 root couchdb 3494 Dec  2 11:34 stunnel.client.cert.pem

Stunnelクライアントの設定

サーバ側はSSLクライアント認証が有効なので、普通に接続しようとすると失敗します。

接続用Certificateファイルの作成

いつも通りにCA.plを使って、newcert.pem,newkey.pemファイルを作成します。

CA.plへのパスはUbuntu 10.04 LTSでのものです。環境毎に格納場所が違いますので、locate CA.plで探すか、手動でopensslを実行してください。

$ /usr/lib/ssl/misc/CA.pl -newreq
$ /usr/lib/ssl/misc/CA.pl -sign
$ rm newreq.pem
$ cp newcert.pem couchdb.client.cert.pem
$ cp newkey.pem  couchdb.client.key.pem
$ openssl rsa < couchdb.client.key.pem > couchdb.client.nokey.pem
$ cat couchdb.client.cert.pem couchdb.client.nokey.pem > couchdb.client.pem

最終的にはcouchdb.client.pemファイルを使い、stunnelをクライアント化します。

Stunnelサーバ側でのCertificateファイルの更新

最初のコマンドラインにあるようにStunnelサーバは接続に使うcertificateを/usr/local/etc/couchdb/sslcertsに保存しています。

今回作成したcouchdb.client.cert.pemファイルと"CA.pl -sign"の実行時に使ったCAのcacert.pemファイルをstunnelサーバ側に転送しておきます。

Stunnelサーバ側で次のような操作をしておきます。 cacert.pemが既に存在していて、内容が同じであれば省いてください。 内容が違う場合はファイル名を変更してコピーしておく必要があります。

$ sudo cp couchdb.client.cert.pem cacert.pem  /usr/local/etc/couchdb/sslcerts
$ sudo c_rehash  /usr/local/etc/couchdb/sslcerts
Stunnelクライアントモードでの起動

基本的には次のようなコマンドラインでStunnelサーバに接続します。

/usr/bin/stunnel -c -p /usr/local/etc/couchdb/sslcerts/couchdb.client.pem" -d 127.0.0.1:5985 -r 192.168.x.x:6984

ここでの192.168.x.xはStunnelサーバのIPアドレスです。

Stunnelクライアント側にはcouchdb.client.pemファイルをコピーしておき、やはり次のようなコマンドを実行します。

$ sudo cp couchdb.client.pem /usr/local/etc/couchdb/sslcerts/
$ sudo /usr/bin/stunnel -c -p /usr/local/etc/couchdb/sslcerts/couchdb.client.pem" -d 127.0.0.1:5985 -r 192.168.x.x:6984
$ curl -u admin:xxxxxx http://localhost/:5985/_all_dbs

サーバ側はBasic認証が有効になっているのでadmin:xxxxxsはID(admin)とパスワード(xxxxxx)を':'(コロン)で区切って指定しています。

セキュリティ上の考察

Stunnelクライアントからはログインできるユーザは全てサーバに到達する事が可能になります。

もちろんパスワードがわからなければ接続できませんが、curlコマンドラインを起動する場合にはps auxwwwの出力にはでないですが、bash等、使っているシェルのhistoryには記録されます。

それが気になることはあまりないとは思いますが、こういうところにも気を配る必要があるかないか、環境はちゃんと理解しておくことが必要です。

さいごに

とりあえず、ここまでで無事にレプリケーションを有効にする準備ができました。

やっぱりセキュリティ周りの作りはちょっと不安なんですよね。

2011/01/09

CouchDB: Viewでのkeyの並び順(Order)の確認レシピ

CouchDBでViewを作成して、startkey、endkeyで条件を指定する時に、優先順位がいまいち分かりずらいので検証するための環境を作ってみました。

あらかじめ準備しておくものは次のものです。

  • CouchDB本体 (今回は1.0.1を準備しました)
  • Ruby (今回はjsonライブラリが用意されているRuby1.9を使います。Ruby 1.8を使用する場合にはjsonライブラリを別途御準備ください。curlでの代用も可能ですが、十分な注意が必要です)
  • テスト文書作成用DB (今回は"example"を使用しますが、任意の名前で結構です)

併わせて参考のために本家のCouchDB Wiki - View_collationを確認すると良いでしょう。

とりあえず結論

結果だけを知りたいという方のために、最初に今回の結果を載せておきます。

とりあえず"id"は無視して、keyの右辺の並びを上から順に眺めてください。

/example/_design/order/_view/orderの表示結果

{"id"=>"ordercheck.12", "key"=>nil, "value"=>nil}
{"id"=>"ordercheck.2", "key"=>false, "value"=>nil}
{"id"=>"ordercheck.4", "key"=>true, "value"=>nil}
{"id"=>"ordercheck.14", "key"=>-1, "value"=>nil}
{"id"=>"ordercheck.5", "key"=>1, "value"=>nil}
{"id"=>"ordercheck.3", "key"=>10, "value"=>nil}
{"id"=>"ordercheck.11", "key"=>"", "value"=>nil}
{"id"=>"ordercheck.0", "key"=>"a", "value"=>nil}
{"id"=>"ordercheck.15", "key"=>"bcd", "value"=>nil}
{"id"=>"ordercheck.10", "key"=>"z", "value"=>nil}
{"id"=>"ordercheck.13", "key"=>"\uFFF0", "value"=>nil}
{"id"=>"ordercheck.6", "key"=>[0, 1], "value"=>nil}
{"id"=>"ordercheck.9", "key"=>[0, 3, 2], "value"=>nil}
{"id"=>"ordercheck.7", "key"=>[1], "value"=>nil}
{"id"=>"ordercheck.8", "key"=>[1, nil, ""], "value"=>nil}
{"id"=>"ordercheck.16", "key"=>[1, 2], "value"=>nil}
{"id"=>"ordercheck.1", "key"=>{}, "value"=>nil}

nilからfalse,trueの順に並んでいく様子がわかります。

nil → 真偽値(false→true) → 数値 → 文字列 → 配列 → ハッシュ

配列の場合は基本的に先頭から要素の有無でまずソートされ、その次に要素の値でソートされています。 要素の数は重要ではない事がわかります。

この配列の扱いは個人的にViewの定義を考える時に混乱するところですが、Viewがちゃんとソートされていればlimit, skipを使って部分的な結果を得て、そのままWebページなりエンドユーザに出力することが出来るので便利なはずです。

作業の流れ

今回はCouchDB内に実際に文書とViewを作成します。その結果を表示する事で、どういった順序でソートされるのかを確認します。

作成する文書

文書の構造は次の通りです。

{
  "_id":"check_order.11",
  "_rev":"1-77356980318a930bb8afc1e6193fa981",
  "k":""
}

"k"に真偽値やら数値やらを代入していきます。

Map関数

"k"をキーにしています。Reduce関数は定義していません。

function(doc) {
  if(doc._id.indexOf('check_order.') == 0) {
    emit(doc.k, null);
  }
}
作成したViewの表示

最終的には最初に載せたような結果が得られ、優先順位は次のようになっている事がわかります。

nil → 真偽値(false→true) → 数値 → 文字列 → 配列 → ハッシュ

今回はこういう結果を出力するスクリプトを準備しておいて、どういう並び順になるか確認するための環境を作ります。

スクリプトの準備

流れに従って、文書作成用のスクリプトを作成する前にCouchモジュールに対するWrapperモジュールを作成しておきます。

ディレクトリ・ファイル構造

今回は"test"ディレクトリをトップディレクトリとして、相対的にlib, initdb, viewsディレクトリを作成していきます。libディレクトリ名は固定で、各スクリプトから"../lib"にパスを通します。

"lib"ディレクトリと同じレベルに存在すれば、"initdb", "views"ディレクトリ名は任意の名前に変更できます。

  • test/lib … ライブラリディレクトリ ("lib"ディレクトリ名は変更不可)
  • test/lib/couchdb.rb … CouchDB Wikiに掲載されているCouchモジュール
  • test/lib/util.rb … Couchモジュールにエラー処理を追加したWrapperモジュール
  • test/initdb … 文書作成用ディレクトリ (ディレクトリ名は変更可)
  • test/initdb/init_docs.rb … 文書を作成するスクリプト
  • test/initdb/show_all_docs.rb … 作成されている文書を全て表示するスクリプト
  • test/initdb/remove_docs.rb … 任意の_idを持つ文書を削除するスクリプト
  • test/views … View作成用ディレクトリ (ディレクトリ名は変更可)
  • test/views/_design.views.order.rb … Viewを作成するスクリプト
  • test/views/show_views.rb … 作成したViewを表示するスクリプト
lib/util.rbの作成

require 'couchdb'で呼び出しているライブラリは、Couch Wikiの「Getting started with Ruby」に掲載されているCouchモジュールです。

先頭にあるDBNameには文書を作成するために使用する、作成済みDB名を'/'から始めて書いてください。

次にYaCouch::getCouchの中を適宜変更して、Couch::Serverクラスのインスタンスをcouchに代入できるようにオプションを適宜変更します。

util.rbファイル全体

# -*- coding: utf-8 -*-

require 'json'
require 'uri'
require 'couchdb'

module YaCouch
  DBname = '/example'
  def YaCouch::getCouch
    ## couch = Couch::Server.new('user'=>'admin', 'password'=>'')
    couch = YaCouch::Main::getCouchAsAdmin
    return YaCouch::Main.new(couch)
  end
  class Main
    require 'json'
    require 'uri'
    def initialize(couch = nil, debug = false)
      @couch = couch
      @debug = debug
    end
    def get(uri)
      json = Hash.new
      begin
        res = @couch.get(URI.escape(uri))
        json = JSON.parse(res.body)
      rescue
        p $! if @debug
      end
      json = Hash.new if json.has_key?("error")
      json
    end
    def put(uri, json)
      res = nil
      begin
        res = @couch.put(URI.escape(uri), json.to_json)
      rescue
        p $! if @debug
      end
      res
    end
    def post(uri, json)
      res = nil
      begin
        res = @couch.post(URI.escape(uri), json.to_json)
      rescue
        p $! if @debug
      end
      res
    end
    def delete(uri)
      res = nil
      begin
        res = @couch.delete(URI.escape(uri))
      rescue
        p $! if @debug
      end
      res
    end
  end
end
initdb/init_docs.rbの作成

文書名(_id)は、「"check_order." + 数字」にしていますが、何でも構いません。

init_docs.rbファイル全体

#!/usr/bin/env ruby

$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'

@couch = YaCouch::getCouch
@num = 0
def up(json_value)
  uri = YaCouch::DBname + '/check_order.' + @num.to_s
  json = @couch.get(uri)
  json["k"] = json_value
  res = @couch.put(uri, json)
  @num += 1
end

## prepare documents
up("a")
up(Hash.new)
up(false)
up(10)
up(true)
up(1)
up([0,1])
up([1])
up([1,nil,""])
up([0,3,2])
up("z")
up("")
up(nil)
up("\ufff0")
up(-1)
up([0,4])
up("bcd")
up([1,2])
views/_design.views.order.rbの作成

Viewを作成するポイントは "/example/_design/order" です。

_design.views.order.rbファイル全体

#!/usr/bin/env ruby

$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'

@couch = YaCouch::getCouch
uri = YaCouch::DBname + "/_design/order"
json = @couch.get(uri)
json['language'] = 'javascript'
json['views'] = Hash.new
json['views']['order'] = Hash.new
json['views']['order']['map'] = <<-MAP
function(doc) {
  if(doc._id.indexOf('check_order.') == 0) {
    emit(doc.k,null);
  }
}
MAP
res = @couch.put(uri,json)
p res.body
views/show_views.rb

show_views.rbファイル全体

#!/usr/local/bin/ruby

$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'
@couch = YaCouch::getCouch

uri = YaCouch::DBname + "/_design/order/_view/order"
json = @couch.get(uri)
json['rows'].each do |row|
  p row
end

このスクリプトの実行結果は、最初に掲載したようなdoc.kをキーとしてソートされた文書のリストになります。

まとめ

タイトルを「〜レシピ」にしたので、その体裁で書こうと思ったものの、挫折しました。

それはさておき、Rubyで使えるライブラリはいろいろありますが、手元の環境ではStunnel4を使い、CouchDBサーバはSSLクライアント認証を有効にしているため、接続部分をカスタマイズする必要があります。

テストのためにApacheのmod_proxyを使ってDigest認証での接続も出きるようにしていますが、いずれにしてもデフォルトの接続処理のセキュリティに満足していないので、低レベルなCouchモジュールに手を入れて使っています。

そんな事をしていないのであれば他のライブラリに慣れるのが良さそうですが、その場合でもこのスクリプトを大きく変更する必要はないと思います。

Appendix. 追加スクリプト

処理の本筋ではない、initdb/show_all_docs.rb と initdb/remove_docs.rb スクリプトを掲載しておきます。

initdb/show_all_docs.rb

show_all_docs.rbファイル全体

#!/usr/bin/env ruby

$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'
@couch = YaCouch::getCouch
uri = YaCouch::DBname + '/_all_docs?include_docs=true'
json = @couch.get(uri)
json['rows'].each do |row|
  p row['doc']
end
initdb/remove_docs.rb

引数無しに実行すると、内部でdelete_doc_prefix変数に設定されている"_id"名が"check_order."で始まる文書が削除されます。

View定義を削除する時には引数に "_design"を指定してください。

remove_docs.rbファイル全体

#!/usr/bin/env ruby
$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'

delete_doc_prefix ='check_order.'
delete_doc_prefix = ARGV[0] if ARGV.length == 1

@couch = YaCouch::getCouch
uri = YaCouch::DBname + '/_all_docs?include_docs=true'
json = @couch.get(uri)
json['rows'].each do |row|
  d = row['doc']
  if d['_id'] =~ /^#{delete_doc_prefix}/
    uri = format("%s/%s?rev=%s", YaCouch::DBname, d['_id'], d['_rev'])
    res = @couch.delete(uri)
    p res.body
  end
end

2010/12/15

CouchDB: Implementation of SELECT COUNT(DISTINCT field)...

In CouchDB, the operation with group=true provides separate values for each unique key, like SELECT DISTINCT SQL query.

Next, we can get the total number of unique keys from the above results, like SELECT COUNT(DISTINCT ...) SQL query.

However, if the first results set is quite big, then the second count-up operation will spend a long time. It might be a problem.

Some examples ...

My ruby client can calculate the number of unique keys like following operation;

A example of ruby couchdb client.

couch = Couch::Server.new(@host, @port)
json = JSON.parse(couch.get(URI.escape('/example/_design/all/_view/test?group=true')).body)
total_keys = json['rows'].length

The processing time of the json to array conversion is so trivial, but the resident memory size and network traffic will be increased by this operation.

I implemented the operation with group_numrows=true like group=true, it returns just the length of the 'rows' array.

As an example, a curl command line returns the following results.

$ curl 'http://localhost:5984/example/_design/all/_view/all?group=true'
{"rows":[
{"key":["bar","35"],"value":3},
{"key":["foo","25"],"value":3},
{"key":["somebody","20"],"value":8},
{"key":["yasu","32"],"value":4}
]}

The operation with gorup_numrows=true returns the following line.

$ curl 'http://localhost:5984/example/_design/all/_view/all?group=true&group_numrows=true'
{"group_numrows":"4"}

If you use the limit=2 operation with above example, the results will be {"group_numrows":"2"}. So it's just return the total number which should be returned.

System Information

The patch file is available from the following link.

This patch was developed;

  • Ubuntu 10.04.1 LTS x86_64
  • Erlang R13B03

I'm not sure this implementation is robust enough to any production use, but I've been testing it with the jQuery flexbox plugin at http://www.yadiary.net/postal/main.fcgi.

Sorry it's Japanese only, but if you use pull-down selection boxes, you can see the results will be changed by your privious box's selection. Each selection boxes desn't have an entire results set, the group_numrows=true operation is used to show you the total number.

About performance

In my last blog post, the group_numrows=true operation is 8.5 times faster than first json['rows'].length case.There are almost 100K result lines (almost 3MB json string.)

My implementation is not smart, it just replaces the string output function to my count-up function.

If you have huge results set and just needs the total number and small subset of the results, this might be useful.

Thank you.

CouchDB: group_numrows拡張のパフォーマンス

修正したコードを使ってVMWare上のCouchDBサーバに対して、118,924件の郵便番号を数えた場合の速度を比較してみました。

元々のDBの構造はCSVファイルを1文書に変換したもので、詳細は 以前の記事にあります。

その他のmap/reduce関数の定義、データ取得用スクリプトは次のとおりです。

viewを作成するためのmap,reduce関数

json['views']['code']['map'] = <<-MAP
function(doc) {
  if(doc._id.length == 40) {
    emit(doc.code, 1)
  }
}
MAP
json['views'][label]['reduce'] = "_sum"

使用したRubyスクリプト

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-

require 'csv'
require 'couchdb'
require 'json'
require 'uri'

couch = Couch::Server.new("localhost","5984")

def show(couch, uri)
begin
  res = couch.get(URI.escape(uri))
  json = JSON.parse(res.body)
p json['group_numrows'] if json.has_key?('group_numrows')
p json['rows'].length if json.has_key?('rows')
rescue
  p $!
end
end
#uri = YaCouch::DBname + '/_design/all/_view/code?group=true'
#show(couch, uri)
uri = YaCouch::DBname + '/_design/all/_view/code?group=true&group_numrows=true'
show(couch, uri)

これにtimeコマンドを使って実行速度を測ってみました。

VMWareを使うとディスクアクセスは特にホストOSのファイルキャッシュの影響を強く受ける傾向があると感じているので、何回か両方のスクリプトを実行した後に計測を始め、各2回目の結果を載せています。

Array.lengthを使って重複を取り除いたキーの数を数える方法

配列の数を数え上げるわけですが、各要素は、 {"key"=>"9998524", "value"=>1}、のような形式になっています。

118924

real	0m8.183s
user	0m4.188s
sys	0m3.812s

group_numrowsパラメータでCouchDBから取得する方法

この戻り値は単純で、クライアントが受け取るのは、 {"group_numrows":"118924"}の一行だけです。 スクリプトの最後の4行のコメントを変更して、同じように実行しています。

"118924"

real	0m0.952s
user	0m0.132s
sys	0m0.052s

Array.lengthを計算しない、JSON.parseを実行しない場合の速度

スクリプトをちょっと変更して、res = couch.get(URI.escape(uri))行の次にreturnを挿入して、すぐに戻るようにしてみました。

real	0m7.796s
user	0m3.784s
sys	0m3.836s

今回の環境では、ほとんどネットワークトラフィックの影響が時間に大きな影響を与えていて、JSON.parse()自体が時間を取っているわけではない事がわかります。

まとめ

この後に実環境でも試しましたが、おおむね同じような結果になりました。

ただし、group_numrowsを使った場合の実時間が最大1.4[s]程度、配列を取得する場合の時間が最小5.7[s]程度となり、その差は縮まっています。

erlangの軽量プロセスについて、もう少し勉強して何か不備はないか確認しようと思います。

2010/12/14

CouchDBでSELECT COUNT(DISTINCT ...)をするために必要なこと

CouchDBを使うためのネタとして 郵便番号検索 (http://www.yadiary.net/postal/)を作成しています

ここで入力をサポートするためにjQueryプラグインのFlexBoxから、候補を検索するためのQueryを投げて、CouchDBから候補となるkeyを取り出しています。

このFlexBoxは必要に応じてリクエストを投げていて、全件数を内部的に持つことはしていません。
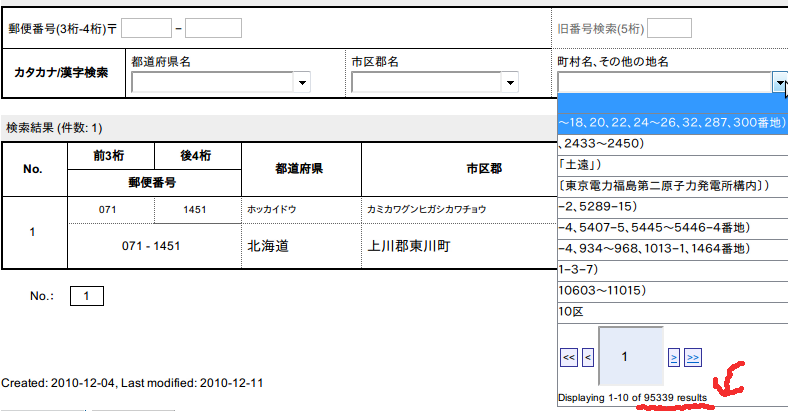
町村名、その他地名をすべて数え上げた時に9万5千件の先頭10個が表示されている画面イメージ

この画像ではFlexBoxに表示されるべき候補が9万5千件あって、その先頭10件が表示されている様子を示しています。 この数字は、各ページの先頭に編集中の文字列が追加されているので、実数からページ数分だけ水増しされています。

この9万5千件という数字は、FlexBoxからの10件毎のQueryへの返信に加える必要があります。

つまり通常のCouchDBで普通に作成すると、毎回の問い合わせの返信内容は10件の内容なのに、全件数を追加するために、内部的にはこの9万5千件のデータを取得して件数の数字だけを作る事になります。

もちろんサーバ側で9万5千という数字をキャッシュする事は可能で、今回も9万5千件という数字もFastCGIの起動時に計算して保持しています。

他の数字についてもキャッシュする事は可能です。 しかし、今回はホスティング環境(DTIのVPS - Entry)でのメモリの制約があります。

RubyスクリプトでHashオブジェクトによる試作では、FastCGI RubyスクリプトのResident Memoryのサイズ上昇が許容範囲を越えていました。

そこでCouchDBだけに負荷を押し付けて、件数を返す機能を追加することにしました。

前書きの後の前書き 〜 技術的背景の説明

CouchDBに関連するドキュメントでは、いわゆる重複を取り除いた結果を取り出すためのSQLでいうところの SELECT DISTINCT に相当する方法として、VIEWについてmap/reduceの両関数を定義して、 group=trueを引数に加える方法を紹介しています。

この時のreduce関数は組み込みの"_sum"や"_count"にするのが一般的でしょう。

大抵はこれで問題ありませんが、SELECT DISTINCTした結果が、それでも比較的大きかった場合に、その全数を数え上げるための方法が問題になります。

ここでは一度JSONをHashオブジェクト等に変換して、その長さを求めることを考えます。

クライアント例:/examples/_design/allに、View名allを設定している場合に、allの結果を数え上げる


@couth = Couch::Server.new("localhost", "5984")
uri = '/examples/_design/all/_view/all?group=true'
json = JSON.parse(@couch.get(URI.escape(uri)).body)
printf "num of distinct rows: %d\n", json['rows'].length
num of distinct rows: 1039

この時にクライアント側のHashオブジェクト(json)は大量のメモリを消費します。 戻り値(@couch.get(...).body)をテキストとしてパースする事もできますが、それでも、ネットワーク帯域とレイテンシの観点からみて、大量のStringオブジェクトを経由する処理は効率的とはいえません。

今回はSQLでいうところの SELECT COUNT(DISTINCT field) FROM tableに相当する処理をCouchDBにさせてみる事を考えました。

まず結論から

今回の方法は軽量プロセスを生成して、Group化された結果(e.x. {"key"=>"三重県", "value"=>2473})を表示する部分で回数だけを軽量プロセスにカウントさせて、最後にその結果だけを受け取って軽量プロセスを終了させる方法をとりました。

タイムアウトやらのエラー処理は十分ではないですし、linkしていないためにプロセスが滞留する可能性もあるかもしれません。

結果はおもしろくなりましたが、かなりad-hocなパッチになっている事はご理解ください。

また軽量プロセスのプログラミングについては、 Erlang Worldを参考にさせて頂き、ほぼその内容に依っています。

基本事項の確認 - group=trueな時のCouchDBの内部動作

CouchDBへViewを設定すると、保持しているドキュメントの一部をキーとしてまとめて表示したり(map関数)、そのまとめたドキュメントの数を数えたり(reduce関数)することができます。

さらにgroup=trueを追加してリクエストを投げると、そのキーの重複を排除して表示することができます。

しかし、この重複を排除したキーの合計数を取り出す仕組みがないために、今回のようにメモリが潤沢でなかったり、reduceしてもまだ結果が大きい場合に問題が起こります。

CouchDBがgroup=true時にやっていること、と解決へのアプローチ

内部での処理は、ほぼ apache-couchdb-1.0.1/src/couchdb/couch_httpd_view.erl で完結しています。

先頭からいくつかの関数の連鎖を通って、send_json_reduce_row(Resp, {Key, Value}, RowFront)関数が出力する文字列(e.x. {"key"=>"三重県", "value"=>2473})を作っています。

send_json_reduce_row関数

send_json_reduce_row(Resp, {Key, Value}, RowFront) ->
    send_chunk(Resp, RowFront ++ ?JSON_ENCODE({[{key, Key}, {value, Value}]})),
    {ok, ",\r\n"}.

本質的にはこの関数を呼び出しているDatabase Engine部分に手を入れ、件数をカウントさせて、関数の戻り値に入れれば良さそうですが、いまのsend_json_reduce_rowの引数をみると、戻り値を受けられるような余地はありません。

内部的には出力を素早く行なうための機能に特化しているようにみえて、今回は、このsend_json_reduce_row関数が呼び出された回数を数えることにしました。

内部的にグローバル変数のようなものを持たせるわけにはいかないので、処理の前半で軽量プロセスを作成して、その後に呼ばれる関数引数を増やしてそのPidを適当な処理まで渡しています。

変数"Pid"に注目すればコードを追うのは簡単だと思います。パッチ本体とファイルへのリンクはこの記事の最後に載せました。

使い方 - 追加したオプションパラメータ

今回はgroup=trueと併用する group_numrowsというパラメータを増やしました。

例えば 郵便番号検索Databaseに入っている都道府県(pref)について、group=trueをした場合の件数(47)を数えると次のようになります。

$ curl -u reader:xxxxxx 'http://localhost:5984/postal/_design/all/_view/pref?group=true&group_numrows=true'

この出力は次の通りです。

{"group_numrows":"47"}

group_numrows=falseとした時の出力(の一部)は次の通りです。 "value"の数字は郵便番号DBの全レコード12万件中の何件分かを表していることになります。

{"rows":[
{"key":"\u4e09\u91cd\u770c","value":2473},
{"key":"\u4eac\u90fd\u5e9c","value":6658},
... ## 47都道府県分のデータが続く 

さらに郵便番号的に、第二フィールドの市区郡(city)の全数はいくつあるのか数えると…

$ curl -u reader:xxxxxx 'http://localhost:5984/postal/_design/all/_view/city?group=true&group_numrows=true'

この出力は次の通りです。

{"group_numrows":"1899"}

これが役に立つのはgroup=trueで返される文字列が、その環境では大き過ぎる場合です。

CouchDB内部で節約できている処理は出力用文字列を生成する部分だけですから、何かB-Treeをトリッキーな方法でtraverseしているわけではありません。

この他のアプロートとしては、RDBMSが中間結果を保持する一時テーブルのように、あらかじめオリジナルの文書群から、中間処理用の文書群を生成しておくこともできるはずです。

まとめ

SQLでいうところのSELECT COUNT(DISTINCT field)が使えないのは、CouchDBのskip, limitパラメータの威力を弱めてしまっていると思います。

jQueryプラグインのFlexBoxとCouchDBは組み合せると、かなり大きなデータも扱う事ができそうだという事が実感できました。

次はFlexBoxのcache更新のタイミングが問題でしょうか…。

Appendix. CouchDB 1.0.1用パッチ

diff -ur apache-couchdb-1.0.1.orig/src/couchdb/couch_db.hrl apache-couchdb-1.0.1/src/couchdb/couch_db.hrl

2010


--- apache-couchdb-1.0.1.orig/src/couchdb/couch_db.hrl	2010-07-20 07:59:53.000000000 +0900
+++ apache-couchdb-1.0.1/src/couchdb/couch_db.hrl	2010-12-14 09:54:37.000000000 +0900
@@ -190,6 +190,7 @@
     skip = 0,
 
     group_level = 0,
+    group_numrows = false,
 
     view_type = nil,
     include_docs = false,
diff -ur apache-couchdb-1.0.1.orig/src/couchdb/couch_httpd_view.erl apache-couchdb-1.0.1/src/couchdb/couch_httpd_view.erl
--- apache-couchdb-1.0.1.orig/src/couchdb/couch_httpd_view.erl	2010-08-08 11:25:40.000000000 +0900
+++ apache-couchdb-1.0.1/src/couchdb/couch_httpd_view.erl	2010-12-14 10:08:16.000000000 +0900
@@ -155,15 +155,22 @@
         group_level = GroupLevel
     } = QueryArgs,
     CurrentEtag = view_group_etag(Group, Db),
+    Pid = case get_group_numrows_type(Req) of 
+            true -> spawn(fun() -> group_numrows_server() end);
+              _  -> false
+          end,
     couch_httpd:etag_respond(Req, CurrentEtag, fun() ->
         {ok, GroupRowsFun, RespFun} = make_reduce_fold_funs(Req, GroupLevel,
                 QueryArgs, CurrentEtag, Group#group.current_seq,
-                #reduce_fold_helper_funs{}),
+                #reduce_fold_helper_funs{}, Pid),
         FoldAccInit = {Limit, Skip, undefined, []},
         {ok, {_, _, Resp, _}} = couch_view:fold_reduce(View,
                 RespFun, FoldAccInit, [{key_group_fun, GroupRowsFun} |
                 make_key_options(QueryArgs)]),
-        finish_reduce_fold(Req, Resp)
+        case get_group_numrows_type(Req) of
+          true -> finish_reduce_fold(Req, Resp, [], Pid);
+             _ -> finish_reduce_fold(Req, Resp)
+        end
     end);
 
 output_reduce_view(Req, Db, View, Group, QueryArgs, Keys) ->
@@ -173,10 +180,14 @@
         group_level = GroupLevel
     } = QueryArgs,
     CurrentEtag = view_group_etag(Group, Db, Keys),
+    Pid = case get_group_numrows_type(Req) of 
+            true -> spawn(fun() -> group_numrows_server() end);
+              _  -> false
+          end,
     couch_httpd:etag_respond(Req, CurrentEtag, fun() ->
         {ok, GroupRowsFun, RespFun} = make_reduce_fold_funs(Req, GroupLevel,
                 QueryArgs, CurrentEtag, Group#group.current_seq,
-                #reduce_fold_helper_funs{}),
+                #reduce_fold_helper_funs{}, Pid),
         {Resp, _RedAcc3} = lists:foldl(
             fun(Key, {Resp, RedAcc}) ->
                 % run the reduce once for each key in keys, with limit etc
@@ -190,7 +201,10 @@
                 {Resp2, RedAcc2}
             end,
         {undefined, []}, Keys), % Start with no comma
-        finish_reduce_fold(Req, Resp, [{update_seq,Group#group.current_seq}])
+        case get_group_numrows_type(Req) of
+          true -> finish_reduce_fold(Req, Resp, [{update_seq,Group#group.current_seq}], Pid);
+             _ -> finish_reduce_fold(Req, Resp, [{update_seq,Group#group.current_seq}])
+          end
     end).
 
 reverse_key_default(?MIN_STR) -> ?MAX_STR;
@@ -203,6 +217,9 @@
 get_reduce_type(Req) ->
     list_to_existing_atom(couch_httpd:qs_value(Req, "reduce", "true")).
 
+get_group_numrows_type(Req) ->
+    list_to_existing_atom(couch_httpd:qs_value(Req, "group_numrows", "false")).
+
 load_view(Req, Db, {ViewDesignId, ViewName}, Keys) ->
     Stale = get_stale_type(Req),
     Reduce = get_reduce_type(Req),
@@ -303,6 +320,8 @@
     [{reduce, parse_bool_param(Value)}];
 parse_view_param("include_docs", Value) ->
     [{include_docs, parse_bool_param(Value)}];
+parse_view_param("group_numrows", Value) ->
+    [{group_numrows, parse_bool_param(Value)}];
 parse_view_param("list", Value) ->
     [{list, ?l2b(Value)}];
 parse_view_param("callback", _) ->
@@ -385,6 +404,8 @@
 % Use the view_query_args record's default value
 validate_view_query(include_docs, _Value, Args) ->
     Args;
+validate_view_query(group_numrows, _Value, Args) ->
+    Args;
 validate_view_query(extra, _Value, Args) ->
     Args.
 
@@ -393,7 +414,7 @@
         start_response = StartRespFun,
         send_row = SendRowFun,
         reduce_count = ReduceCountFun
-    } = apply_default_helper_funs(HelperFuns),
+    } = apply_default_helper_funs(HelperFuns, Req, Req),
 
     #view_query_args{
         include_docs = IncludeDocs
@@ -425,10 +446,13 @@
     end.
 
 make_reduce_fold_funs(Req, GroupLevel, _QueryArgs, Etag, UpdateSeq, HelperFuns) ->
+  make_reduce_fold_funs(Req, GroupLevel, _QueryArgs, Etag, UpdateSeq, HelperFuns, nil).
+
+make_reduce_fold_funs(Req, GroupLevel, _QueryArgs, Etag, UpdateSeq, HelperFuns, Pid) ->
     #reduce_fold_helper_funs{
         start_response = StartRespFun,
         send_row = SendRowFun
-    } = apply_default_helper_funs(HelperFuns),
+    } = apply_default_helper_funs(HelperFuns, Req, Pid),
 
     GroupRowsFun =
         fun({_Key1,_}, {_Key2,_}) when GroupLevel == 0 ->
@@ -488,7 +512,7 @@
         #view_fold_helper_funs{
             start_response = StartResp,
             send_row = SendRow
-        }=Helpers) ->
+        }=Helpers, _Req, _Pid) ->
     StartResp2 = case StartResp of
     undefined -> fun json_view_start_resp/6;
     _ -> StartResp
@@ -504,19 +528,21 @@
         send_row = SendRow2
     };
 
-
 apply_default_helper_funs(
         #reduce_fold_helper_funs{
             start_response = StartResp,
             send_row = SendRow
-        }=Helpers) ->
+        }=Helpers, Req, Pid) ->
     StartResp2 = case StartResp of
     undefined -> fun json_reduce_start_resp/4;
     _ -> StartResp
     end,
 
     SendRow2 = case SendRow of
-    undefined -> fun send_json_reduce_row/3;
+    undefined -> case get_group_numrows_type(Req) of
+                   true -> gen_send_json_reduce_row(Pid);
+                      _ -> fun send_json_reduce_row/3
+                 end;
     _ -> SendRow
     end,
 
@@ -586,6 +612,24 @@
     send_chunk(Resp, RowFront ++ ?JSON_ENCODE({[{key, Key}, {value, Value}]})),
     {ok, ",\r\n"}.
 
+gen_send_json_reduce_row(Pid) ->
+  fun(_Req, _KV, _RowFront) ->
+    Pid ! {countup},
+    {ok, ",\r\n"}
+  end.
+
+group_numrows_server() ->
+  group_numrows_server(0).
+group_numrows_server(X) ->
+  receive
+    {status, From} ->
+      From ! X, group_numrows_server(X);
+    {countup} ->
+      group_numrows_server(X+1);
+    {stop, From} ->
+      From ! X
+  end.
+
 view_group_etag(Group, Db) ->
     view_group_etag(Group, Db, nil).
 
@@ -651,6 +695,25 @@
 finish_reduce_fold(Req, Resp) ->
     finish_reduce_fold(Req, Resp, []).
 
+get_group_numrows_final_results(Pid) ->
+  Pid ! {stop, self()},
+  receive
+    X -> X
+  end.
+
+finish_reduce_fold(Req, Resp, Fields, Pid) ->
+    case Resp of
+    undefined ->
+        send_json(Req, 200, {[
+            {rows, []},
+            {group_numrows, 0}
+        ] ++ Fields});
+    Resp ->
+        X = get_group_numrows_final_results(Pid),
+        send_chunk(Resp, "{\"group_numrows\":\"" ++ integer_to_list(X) ++ "\"}"),
+        end_json_response(Resp)
+    end.
+ 
 finish_reduce_fold(Req, Resp, Fields) ->
     case Resp of
     undefined ->
2010/12/11

FlexBoxの検索を絞るためにQueryにキーを追加してみる

前回は 郵便番号検索の中で、町村名などを入力する際に jQueryプラグインのFlexBoxを使って動的に検索結果を表示させました。

配列などで静的に候補を指定する場合には、対応するautocomplete系のjQueryプラグインは複数あります。 都道府県レベルでは、これでも十分に対応できます。

しかし郵便番号データベースに登録された市区郡以下の町村レベルになると、9万5千件を越えるアイテムがあります。 前回からjQueryプラグインのFlexBoxを使うことで、page, sizeの指定による部分的な結果を要求するFlexBoxは対象数が大きな場合に効果的である事がわかりました。

とはいえ、他にキーとなる入力があれば、それを一緒に渡す事でさらに検索対象を狭めることが期待できます。 これはエンドユーザへのより適切な選択肢の提供を目的としたものです。

今回は完全一致が期待できる都道府県名に注目をして、ここに値が入力されていた場合には、その都道府県名をキーとして町村名の検索範囲を狭めることにしました。

これによって大量の候補を扱う事によるメモリの消費も抑える事ができ、全体的な印象はかなり改善されたと思います。

変更したFlexBoxの動きについて

FlexBoxが動的に候補を表示する場合に使うQUERY_STRINGのkeyは、"s","p","q","contentType"の4つだけでした。 今回はこのkeyに kを追加します。

"k"に対応する値には $(QueryKey).val()の結果を渡すようにしていて、この"QueryKey"自体はオプションとして指定された文字列です。

QueryKeyの値としては、"#input-pref"のようなセレクタを想定しています。

アクセスログに残っているリクエス行は次のようなものでした。

... "GET /postal/street.1.4.fcgi?q=&p=1&s=10&contentType=application%2Fjson%3B+charset%3Dutf-8&k= HTTP/1.1" 200 50 ...

この"k"に指定された値をCouchDBのViewのstartkeyとendkeyに渡すことで検索を行なっています。

変更したFlexBoxの使いどころ

Google Toolbarの検索ボックスのように、単独で入力文字を補完するような場合にはノーマルなFlexBoxが向いていると思います。

今回の変更は、同じ画面で別のフォームに入力された従業員番号などの情報も一緒にした検索を可能にします。 より適切な対象を候補として表示する事が可能になることを期待しています。

自分の目的には2つの値をキーとして渡す事も考えていて、汎用的な拡張は難しいですが、各種の目的に応じて検索候補を要求するqueryを変更するのは良いアイデアのように思えます。

とりあえずjQuery + FlexBoxを使って、いろいろな方法で入力補完を試してみようと思います。

修正した後のアプリケーションの動きについて

現在は 郵便番号検索のトップページから開発版に進むと、FlexBoxを使ったautocompleteを試す事ができます。

いま現在の動きは「都道府県名」を完全に入力した場合に、町村名が補完されるようになります。

サーバはメモリが256MBのプランで、最大512MBまで使えるとはいっても、いろいろキャッシュする事はできません。 とはいえCouchDBと補完用候補検索用のRubyスクリプトはよく動いてくれています。

CouchDBが常に使っている常駐メモリ(RSS)分は23MB、FastCGIのメモリは検索対象の大きな町村名を扱う部分で15MBほどです。 仮想メモリ全体でも100MBほどですから、DTIのVPSを使っている分には正解な感じです。

Alixで使う分にも問題はないのですが、大きなViewを一気に作る時にはCPUパワーが足りない印象です。それでも稼働確認としての動き自体にはやはり問題ありません。

修正したコードのdiff出力

diffの出力は下記のとおりですが、なんというか、小さい変更で良い結果を手に入れることができました。

$ diff -u jquery.flexbox.js.orig jquery.flexbox.js

flexbox 0.9.6に対するdiffの結果

--- jquery.flexbox.js.orig	2010-11-24 13:03:02.000000000 +0900
+++ jquery.flexbox.js	2010-12-11 11:57:56.000000000 +0900
@@ -1,3 +1,9 @@
+/*
+ * This file contains some modification written by Yasuhiro ABE <yasu@yasundial.org>
+ * Copyright (c) 2010 Yasuhiro ABE (http://www.yasundial.org)
+ * Original copyright is following;
+ */
+
 /*!
 * jQuery FlexBox $Version: 0.9.6 $
 *
@@ -53,6 +59,7 @@
         scrolling = false,
         pageSize = o.paging && o.paging.pageSize ? o.paging.pageSize : 0,
 		retrievingRemoteData = false,
+	queryKey = o.queryKey, // added by Yasuhiro ABE
         $div = $(div).css('position', 'relative').css('z-index', 0);
 
         // The hiddenField MUST be appended to the div before the input, or IE7 does not shift the dropdown below the input field (it overlaps)
@@ -252,7 +259,9 @@
                     showPaging(p, cached.t);
                 }
                 else {
-                    var params = { q: q, p: p, s: pageSize, contentType: 'application/json; charset=utf-8' };
+                    //var params = { q: q, p: p, s: pageSize, contentType: 'application/json; charset=utf-8' };
+                    var kQueryString = $(queryKey).val();
+		    var params = { q: q, p: p, s: pageSize, contentType: 'application/json; charset=utf-8', k: kQueryString };
                     var callback = function(data, overrideQuery) {
                         if (overrideQuery === true) q = overrideQuery; // must compare to boolean because by default, the string value "success" is passed when the jQuery $.getJSON method's callback is called
                         var totalResults = parseInt(data[o.totalProperty]);
@@ -848,7 +857,8 @@
             showSummary: true, // whether to show 'displaying 1-10 of 200 results' text
             summaryClass: 'summary', // class for 'displaying 1-10 of 200 results', prefix with containerClass
             summaryTemplate: 'Displaying {start}-{end} of {total} results' // can use {page} and {pages} as well
-        }
+        },
+	queryKey: '' // will be added to the k=$(QueryKey).val() to the outer query url
     };
 
     $.fn.setValue = function(val) {

まとめ

もともと町村名には最大で9万5千件の候補が表示されるようになっていましたが、これ自体はFlexBoxが範囲を区切って候補を要求するためパフォーマンス上の問題ではありませんでした。

しかしユーザには常に9万5千件の一部が表示される状態だったため、検索対象を絞るための情報を有効に活用するのが利便性を向上させるだろうと考えたのが今回のFlexBox改造の動機でした。

CouchDBをバックエンドに持っていて、FastCGIやCouchDBの再起動時にこそ表示が素早く行えないなどの問題がありますが、通常はほぼ問題のないレスポンスを返しているようです。

もちろん利用者が自分だけという理由もありますが、パフォーマンスの改善にはまだ余地があります。 VPSの256MBのプランですし、テストベンチにしてはよく動いていると思います。

JavaScriptについて

関数型言語として興味はありますが、ブラウザのDOMを操作する事にはあまり熱心になれないので、JavaScriptは得意ではありません。

そのためGoogleで多くのJavaScriptについての検索を行ない、いろいろ参考にさせて頂きました。

しかしいくつかの解説の中には"id"値が 文書全体で唯一の要素を指定するために使われるってことをどれぐらい意識しているのかと疑問に思う場面がありました。

JavaScriptを使うと入力をサポートすることができますが、強制する事は何一つできません。

ユーザからの入力は適切な範囲に収まっているかサーバ側で検証する必要があるのは、まず大切なことです。

2010/12/02

Alix上のCouchDBに郵便番号データを入力してみた

LDAPの時も使ったCSV形式で配布されている郵便番号データをCouchDBに入力してみました。

今回の使い方は初期に大量のデータを入力して、使用フェーズではもっぱら参照だけになる、という使い方になるので、CouchDBらしくないとは思ったのですが、Viewを定義してListやShowをテストするのに使おうと思います。

準備したデータの量やハードウェアなどについて

郵便番号データは12万2千件余りで、CouchDBに入力した後のデータサイズはおよそ100MBです。

まずは結論、困った事や思った事

_bulk_docsを使って大量のデータを入力しようとしたのですが、30件程度、サイズで4KB以内程度でないと失敗しました。サイズに上限があるのかどうかは、はっきりしていません。

Alixは256MBしかメモリがないですし、少し特殊なハードウェアですからVMWare上のUbuntu Server 10.04 LTSでメモリを増やして確認しましたが、やはり似たような挙動になりました。

その他にはApacheをSSLで接続するReverse Proxyにした場合のデータスループットは、Stunnelを利用した場合と比較すると、およそ2倍ちょっと遅いという結果になりました。(15分→35分)

これは単純にシングルコア、かつ256MBのメモリで動くAlixにSSLとReverse Proxyが負荷を与えたのかなぁと考えています。 ただ手元のデータでは、ここら辺の考えを証明できてはいません。

最後に全文書を対象に郵便番号をキー(Key)に、文書を値(Value)にするシンプルなViewを追加した場合に、100MBのデータに対して80MB程度のファイルが作成されています。

ここら辺の動きはLDAPと比べても、あまり変わりのないところかなと思いました。

データの加工とCouchDBへの入力

以前LDAPを相手にした時のようなスキーマは必要ないので適当なデータ構造をでっちあげて、次のようなスクリプトを組みました。

カレントディレクトリに置いたcouchdb.rbには前回も使ったCouchDB Wikiにあるサンプルを改造したものを使っています。

あらかじめ /postalにDBを作成しておき、次のようにスクリプトを実行しています。

$ nkf -w ken_all.csv > ken_all.utf8.csv
$ ./initdb.rb ken_all.utf8.csv

initdb.rbスクリプトファイル

#!/usr/bin/env ruby1.9
# -*- coding: utf-8 -*-
##
## CouchDB Wiki : Transactional Semantics with Bulk Updates
## http://wiki.apache.org/couchdb/HTTP_Bulk_Document_API
##

$:.unshift File.dirname($0)

require 'csv'
require 'couchdb'
require 'json'

couch = Couch::Server.new("couchdb.example.org","5984",
         {'user' => 'admin','password' => "xxxxxxxxxxxx"})

uri = '/postal/_bulk_docs'
num = 0
bulk_docs = Hash.new
bulk_docs['non_atomic'] = true
bulk_docs['docs'] = Array.new
entry = Hash.new
CSV.open(ARGV[0], 'r').each do |row|
  ## prepare output format
  entry = Hash.new
  entry['_id'] = "entry." + num.to_s
  entry['num'] = num
  entry['id'] = row[0]
  entry['pref'] = row[6]
  entry['pref_kana'] = row[3]
  entry['city'] = row[7]
  entry['city_kana'] = row[4]
  entry['street'] = row[8]
  entry['street_kana'] = row[5]
  entry['code'] = row[2]
  entry['code_prefix'] = row[1]
  entry['other'] = [row[9],row[10],row[11],row[12],row[13],row[14]]

  bulk_docs['docs'] << entry
  num += 1

  if num % 10 == 9
    res = ""
    while not res.kind_of?(Net::HTTPSuccess)
      begin
        res = couch.post(uri, bulk_docs.to_json)
        if res.kind_of?(Net::HTTPUnauthorized)
          print "num: #{num}, #{res.to_s}\n"
        end
      rescue
        p $!
        p bulk_docs.to_json
        res = ""
      end
    end
    bulk_docs['docs'] = Array.new
  end
end

res = ""
while not res.kind_of?(Net::HTTPSuccess)
  begin
    res = couch.post(uri, bulk_docs.to_json)
    print "num: #{num}, #{res.to_s}\n"
  rescue
    p $!
    res = ""
  end
end

先頭部分は#!/usr/bin/rubyやら/usr/local/bin/rubyやら適当に変更してください。

それとcouch = Couch::Server.new("couchdb.example.org","5984",の行は、それぞれの環境に合せて修正してください。

ここまで終って適当にデータが入っているか確認だけしておきます。

$ curl -u admin:xxxxxxxxxxx http://couchdb.example.org:5984/postal/_all_docs?limit=10
{"total_rows":122971,"offset":0,"rows":[
{"id":"_design/all","key":"_design/all","value":{"rev":"1-5dfb6015c7dde046e055d54f02a2b8d3"}},
{"id":"entry.0","key":"entry.0","value":{"rev":"1-f53d3fc4f2e20aa9a26a642248d442d6"}},
...

出力1行目の total_rowsが12万件を越えているところを確認します。

Viewの追加

テストのために、いくつかの値をキーにする /postal/_design/all文書を加えました。

#!/usr/bin/env ruby1.9
# -*- coding: utf-8 -*-

$:.unshift File.dirname($0)

require 'csv'
require 'couchdb'
require 'json'
require 'uri'

couch = Couch::Server.new("couchdb.example.org","5984",
         {'user' => 'admin','password' => "xxxxxxxxxxxx"})

uri = '/postal/_design/all'

json = Hash.new
## check existing document
begin
  res = couch.get(URI.escape(uri))
  json = JSON.parse(res.body)
rescue
end
json = Hash.new if json.has_key?("error")
p json

## override existing document or write new document
json['language'] = 'javascript'
json['views'] = Hash.new if not json['views'].kind_of?(Hash)
json['views']['by-code'] = Hash.new if not json['views']['by-code'].kind_of?(Hash)
json['views']['by-code']['map'] = <<-MAP
function(doc) {
  if(doc._id.indexOf('entry.') == 0) {
    emit(doc.code, null)
  }
}
MAP
json['views']['by-pref'] = Hash.new if not json['views']['by-pref'].kind_of?(Hash)
json['views']['by-pref']['map'] = <<-MAP
function(doc) {
  if(doc._id.indexOf('entry.') == 0) {
    emit(doc.pref, null)
  }
}
MAP
json['views']['by-street'] = Hash.new if not json['views']['by-street'].kind_of?(Hash)
json['views']['by-street']['map'] = <<-MAP
function(doc) {
  if(doc._id.indexOf('entry.') == 0) {
    emit(doc.street, null)
  }
}
MAP
json['views']['by-code_prefix'] = Hash.new if not json['views']['by-code_prefix'].kind_of?(Hash)
json['views']['by-code_prefix']['map'] = <<-MAP
function(doc) {
  if(doc._id.indexOf('entry.') == 0) {
    emit(doc.code_prefix, null)
  }
}
MAP
res = couch.put(uri, json.to_json)
puts res

ここでも、検索が成功するか確認しておきます。

$ curl -u admin:xxxxxxxxxxx http://couchdb.example.org:5984/postal/_design/all/_view/by-code?key="9650000"&include_docs=true'
{"total_rows":122970,"offset":115550,"rows":[
{"id":"entry.20279","key":"9650000","value":null,"doc":{"_id":"entry.20279","_rev":"1-efbdc6e3516306c14e784eacf30412b8","num":20279,"id":"07202","pref":"\u798f\u5cf6\u770c","pref_kana":"\u30d5\u30af\u30b7\u30de\u30b1\u30f3","city":"\u4f1a\u6d25\u82e5\u677e\u5e02","city_kana":"\u30a2\u30a4\u30c5\u30ef\u30ab\u30de\u30c4\u30b7","street":"\u4ee5\u4e0b\u306b\u63b2\u8f09\u304c\u306a\u3044\u5834\u5408","street_kana":"\u30a4\u30ab\u30cb\u30b1\u30a4\u30b5\u30a4\u30ac\u30ca\u30a4\u30d0\u30a2\u30a4","code":"9650000","code_prefix":"965  ","other":["0","0","0","0","0","0"]}}
]}

このviewを登録すると、だいたい160MBほどの中間ファイルが/usr/local/var/lib/couchdb/.postal_design/に生成されます。

問題なのは時間で、これで1時間半ぐらいでしょうか。 もっともファイルが出来てしまえば動きには問題なくて、検索結果を素早く得る事ができています。

これを元ネタに簡単なWebページを作ってみようと思います。

この記事で取り上げた品々

2010/11/30

CouchDB: Ruby CouchモジュールをDigest認証対応にする

CouchDBのGetting startedには Ruby用のCouchモジュールが掲載されています。

Basic認証に対応させたり、SSLクライアント認証対応にしたりしてきましたが、今回はDigest認証に対応させる事にしました。

これはCouchDBの標準機能ではありません。フロントエンドにApacheなどでProxy Serverを配置し、そのProxy ServerがDigest認証を行なう事を想定しています。

なおDigest認証の仕様は RFC2069 - An Extension to HTTP : Digest Access Authenticationで定義されています。

使い方のサンプル

Couch::Server#newメソッドの第三引数のハッシュに'digest_auth'プロパティを設定します。 他はBasic認証と同じです。

サンプルコード

couch =  Couch::Server.new("couch.example.org","443", {
                           'digest_auth' => 'true',
		           'user' => 'admin',
		           'password' => 'xxxxxxxxxxxx',
		         ...})

他は同じように使えますが、ループの中で繰り返し実行するような場合には#get, #post, #put, #deleteなどの各メソッドで再認証を求められる可能性を考慮する必要があります。

open(file).each_line do |line|
  row = 
  json = Hash.new
  ...
  res = ""
  while not res.kind_of?(Net::HTTPSuccess)
    begin
      res = couch.post(uri, json.to_json)
    rescue
      p $!
    end
  end
end

ライブラリを少し変更すると自動的に再認証することもできますが、最大回数を設定するなどの配慮が必要になるでしょう。

Digest情報のキャッシュ

今回利用したライブラリのサンプルでは再利用の方法について、サンプルはないようでした。

RFC2069では、再利用できる情報としてusername, password, nonce, nonce count and opaque valuesが挙げられています。

これらの情報を使いまわすようにしていますが、手元のApacheを使った環境では5分毎に再認証(rc=401)を求められます。

この挙動への対応として、ライブラリ側でのコントロールをしない方法を選択しました。 オリジナルのライブラリで行なっていたレスポンスコードに応じた例外の送出は行なわれません。

レスポンスオブジェクトはそのままクライアントに返すので、クライアント側では再認証が発生した場合に再度メソッドを呼び出すなど判断をしてください。

net-http-digest_authモジュールの導入

標準ライブラリではDigest認証に対応しません。今回は net-http-digest_authを利用しました。

このライブラリのロードはdigest_authプロパティを設定した場合に発生するので、クライアント側でrubygemsを呼び出すなどの準備が必要です。

couchdb.rbと同じディレクトリにnetディレクトリを配置した場合の設定例

main.rbからcouchdb.rbを呼び出す、次のようなディレクトリ構造を想定しています。

bin/main.rb
lib/
lib/couchdb.rb
lib/net/http/digest_auth.rb

main.rbでは次のようにライブラリをロードします。

netディレクトリを手動で配置した場合の設定例

$:.unshift File.join([File.dirname($0),"..","lib"])
require 'couchdb'
gemsを使う場合の設定例

今回もmain.rbからcouchdb.rbを呼び出す、次のようなディレクトリ構造を想定しています。

$ cd lib
$ gem install -i gems net-http-digest_auth
bin/main.rb
lib/couchdb.rb
lib/gems/gems/net-http-digest_auth-1.0/lib/net/http/digest_auth.rb

標準以外の場所にgemsディレクトリがある場合の対応は以下のようになります。 (-iオプションを使わずに)標準的な場所にインストールした場合には、当然、ENV['GEM_HOME']の行は不要です。

gemsを使う場合の設定例

ENV['GEM_HOME'] = File.join([File.dirname($0),"..","lib","gems"])
require 'rubygems'
$:.unshift File.join([File.dirname($0),"..","lib"])
require 'couchdb'

変更を加えたCouchモジュール

モジュールの全体は次の通りです。

変更したCouchモジュール: lib/couchdb.rb

# -*- coding: utf-8 -*-

require 'net/https'

#
# This module comes from the couchdb wiki;
# http://wiki.apache.org/couchdb/Getting_started_with_Ruby
#
# Modifyed by Yasuhiro ABE - yasu@yasundial.org
#
module Couch

  class Server
    def initialize(host, port, options = nil)
      @host = host
      @port = port
      @options = options
      @options = Hash.new if options.nil? or not options.kind_of?(Hash)
      @www_auth = nil
      @auth = nil
      if options.has_key?('digest_auth')
        require 'net/http/digest_auth'
        @digest_auth = Net::HTTP::DigestAuth.new
      end
    end

    def delete(uri)
      setup_digest_auth(uri,'DELETE')
      request(Net::HTTP::Delete.new(uri))
    end

    def get(uri)
      setup_digest_auth(uri,'GET')
      request(Net::HTTP::Get.new(uri))
    end

    def put(uri, json)
      setup_digest_auth(uri,'PUT')
      req = Net::HTTP::Put.new(uri)
      req["content-type"] = "application/json"
      req.body = json
      request(req)
    end

    def post(uri, json)
      setup_digest_auth(uri,'POST')
      req = Net::HTTP::Post.new(uri)
      req["content-type"] = "application/json"
      req.body = json
      request(req)
    end

    def check_ssl(client)
      if @options.has_key?('cacert')
        client.use_ssl = true
        client.ca_file = @options['cacert']
        client.verify_mode  = @options['ssl_verify_mode'] if @options.has_key?('ssl_verify_mode')
        client.verify_mode  = OpenSSL::SSL::VERIFY_PEER if not @options.has_key?('ssl_verify_mode')
        client.verify_depth = @options['ssl_verify_depth'] if @options.has_key?('ssl_verify_depth')
        client.verify_depth = 5 if not @options.has_key?('ssl_verify_depth')
        client.cert         = @options['ssl_client_cert'] if @options.has_key?('ssl_client_cert')
        client.key          = @options['ssl_client_key'] if @options.has_key?('ssl_client_key')
      end
    end

    def request(req)
      req.basic_auth @options['user'], @options['password'] if @options.has_key?('user') and @options.has_key?('password') and not @options.has_key?('digest_auth')
      req["X-Auth-CouchDB-UserName"] = @options['proxy_auth_user'] if @options.has_key?('proxy_auth_user')
      req["X-Auth-CouchDB-Roles"] = @options['proxy_auth_roles'] if @options.has_key?('proxy_auth_roles')
      req["X-Auth-CouchDB-Token"] = @options['proxy_auth_token'] if @options.has_key?('proxy_auth_token')
      
      client = Net::HTTP.new(@host, @port)
      check_ssl(client)
      
      if @options.has_key?('digest_auth')
        req["Authorization"] = @auth
      end
      
      res = client.start { |http| http.request(req) }
      @www_auth = nil if res.kind_of?(Net::HTTPUnauthorized) and @options.has_key?('digest_auth')
      res
    end
    
    private

    def setup_digest_auth(uri, method)
      return if not @options.has_key?('digest_auth')
      if @www_auth == nil
        req = Net::HTTP::Get.new(uri)
        client = Net::HTTP.new(@host, @port)
        check_ssl(client)
        res = client.start { |http| http.request(req) }
        ## res must be the Net::HTTPUnauthorized
        raise res if not res.kind_of?(Net::HTTPUnauthorized)
        @www_auth = res['www-authenticate']
      end
      url = TinyURI.new(@options['user'], @options['password'], uri)
      @auth = @digest_auth.auth_header(url, @www_auth, method)
    end
  end

  private
  # net/http/digest_auth using this class to pass information.
  class TinyURI  # :nodoc:all
    attr_accessor :request_uri, :user, :password
    def initialize(user, pass, path)
      @user = user 
      @password = pass
      @request_uri = path
    end
  end
end

2010/11/30 22:00追記
認証に失敗した場合に@www_authを初期化するコードが抜けていたので追記しています。

モジュールの使い方: README.rd

手元で書いたREADME.rbの内容をそのまま転載します。

ruby用Couchモジュールについて

http://wiki.apache.org/couchdb/Getting_started_with_Ruby に掲載されているモジュールをベースにしています。

追加した機能は次の通りです。

  • Proxy認証 (couch_httpd_auth:proxy_authentification_handler用)
  • SSLクライアント認証 (stunnelを想定したセキュア接続用)
  • Basic認証 (couch_httpd_auth:default_authentication_handler, apache等proxy serverでの認証用)
  • Digest認証 (apache等proxy serverでの認証用)

基本的な使い方はCouch::Server.new(host,port,options)でインスタンス生成時のoptions引数にハッシュを与えます。

プロパティ認証用プロパティ

optionsにプロパティが設定されていない場合には何もしません。 値がセットされている場合に、各ヘッダにその値を指定します。

  • proxy_auth_user (X-Auth-CouchDB-UserNameヘッダの値にセット)
  • proxy_auth_roles (X-Auth-CouchDB-Rolesヘッダの値にセット)
  • proxy_auth_token (X-Auth-CouchDB-Tokenヘッダの値にセット)

現状ではこれらの値の設定をサポートするメソッドは提供されません。

Basic and Digest認証用プロパティ

認証を有効にするためには、user, password両方とも設定する必要があります。

  • user (任意の文字列)
  • password (任意の文字列)
Digest認証用プロパティ

次の"digest_auth"が設定され、@options.has_key?('digest_auth')がtrueを返す場合に有効です。

  • digest_auth (設定されている場合に有効)

この機能のテストでは{ "digest_auth" => "true" } のようにダミーの文字列を設定しています。

Digest認証を使うクライアントで必要なライブラリのロード

Digest認証を有効にした場合には、net/http/digest_auth モジュールをロードしようとします。

デフォルトでは有効になっていないので、モジュールを適切な方法で配置してください。

方法の1つは次のようにcouchdb.rbと同じディレクトリにnetディレクトリを配置して、相対パスでこのlibディレクトリを$:変数に含める方法です。


  bin/main.rb
  lib/
  lib/couchdb.rb
  lib/net/http/digest_auth.rb

main.rbには次のように記述します。

  $:.unshift File.join([File.dirname($0),"..","lib"])
  require 'couchdb'

方法の2つめはgemsを使い、require 'rubygems'を加える方法です。 デフォルトの場所以外にgemsでインストールした場合には次のように、その場所をポイントする必要があります。

$ gem install -i gems net-http-digest_auth

次のようなディレクトリ構造だとします。


  bin/main.rb
  lib/couchdb.rb
  lib/gems/gems/net-http-digest_auth-1.0/lib/net/http/digest_auth.rb

この場合は、main.rbの先頭は次のようになるでしょう。

  ENV['GEM_HOME'] = File.join([File.dirname($0),"..","lib","gems"])
  require 'rubygems'
  $:.unshift File.join([File.dirname($0),"..","lib"])
  require 'couchdb'

前者の方法はシンプルですがライブラリのメンテナンスを考えるならgemsの利用も検討するべきです。

それにドメイン毎の事情を考慮して、他の方法を検討することはとても素晴しいアプローチです。

SSLクライアント認証用プロパティ

stunnelを使って検証しています。

cacertが設定されている場合に、自動的にNet::HTTP#use_sslを有効にします。 それぞれに設定する値の詳細は、net/httpsのNet::HTTPクラスライブラリを参照してください。

  • cacert (デフォルト値なし。pemファイルへのパス文字列)
  • ssl_verify_mode (default: OpenSSL::SSL::VERIFY_PEER。another value: OpenSSL::SSL::VERIFY_NONE)
  • ssl_verify_depth (default: 5)
  • ssl_client_cert (default値なし。OpenSSL::X509::Certificate オブジェクト)
  • ssl_client_key (default値なし。OpenSSL::PKey::RSA オブジェクト、もしくは、OpenSSL::PKey::DSA オブジェクト)
SSLクライアント認証とBasic認証を組み合せる場合のコーディング例

n少なくとも次のような方法で各オブジェクトを準備し、Couch::Serverクラスのインスタンスを生成する事が必要です。 Basic認証が不要な場合は、user, passwordプロパティを設定しないでください。

詳細はnet/httpsのNet::HTTPクラスライブラリの各メソッドから、OpenSSL:SSLクラスライブラリと併せて参照してください。

  ssl_client_cert = OpenSSL::X509::Certificate.new(File.new(File.expand_path('stunnel.client.cert.pem', File.dirname($0))))
  ssl_client_key = OpenSSL::PKey::RSA.new(File.new(File.expand_path('stunnel.client.key.pem', File.dirname($0))), 'xxxxxxx')

  couch = Couch::Server.new("couch.example.org","5984", {
    'user' => 'admin',
    'password' => 'xxxxxxxxxx',
    'cacert' => File.expand_path('cacert.pem', File.dirname($0)),
    'ssl_client_cert' => ssl_client_cert,
    'ssl_client_key'  => ssl_client_key
  })
SSLサーバ認証について

SSLサーバ認証は、SSLクライアント認証のサブセットで、少なくともcacertプロパティにはサーバ側の証明書が検証できるPEMファイルを設定することが必要です。

その他のプロパティは任意です。

2010/11/29

CouchDB: How to use a reverse proxy server with authentication_db

Japanese edition is here.

A reverse proxy server as a front-end of couchdb seems to be useful for authentication and SSL because there are many examples, such as Apache_As_a_Reverse_Proxy.

According to the couchdb reference, however, it suggests to use the null_authentication_handler and the user=%{LA-U:REMOTE_USER} rewrite rule, it means that an local user will get the admin privilege.

A new authentication handler was developed working with an authentication_db to solve this issue.

If the reverse proxy server and couchdb are placed at different servers, this kind of handler might be useful.

The following patch is for the couchdb-1.0.1, but just added new codes. I think that it should work with another version.

This authentication handler was tested on alix with debian lenny. Some stuffs, especially erlang-R14B and couchdb-1.0.1, were manually compiled.

Setup Procedures

The diff file, 20101127.1.couchdb101.webproxy.diff, are placed at ~/, then move to the couchdb directory and apply it.

$ cd apache-couchdb-1.0.1
$ patch -p1 < ~/20101127.1.couchdb101.webproxy.diff
$ cd src/couchdb
$ make
$ sudo cp couch_httpd_auth.beam /usr/local/lib/couchdb/erlang/lib/couch-1.0.1/ebin/

To use this handler, please modify the local.ini file as following;

authentication_handers setting at local.ini

[httpd]
authentication_handlers = {couch_httpd_auth, webproxy_authentication_handler}

This handler will take two options;

  • require_authentication_db_entry (default: true) - if it's true and the authenticated user name is not on the authentication_db, then the authorization at couchdb will be failed.
  • webproxy_use_secret (default:false) - if it's true and there is no proper X-Auth-CouchDB-Token header, then the access will be denied.

The authentication_db entry is just used to get the user's role. It means just user, type and roles entries are reqruied to each document.

To enable the authentication, you need more configurations usually. Following is an typical example of the local.ini file.

Example of the local.ini file

[httpd]
WWW-Authenticate = Basic realm="administrator"
authentication_handlers = {couch_httpd_auth, webproxy_authentication_handler}

[couch_httpd_auth]
require_valid_user = true
require_authentication_db_entry = true
webproxy_use_secret = false
secret = 329435e5e66be809a656af105f42401e

Set up Apache as A Reverse Proxy

These configurations are just an example. Please modify for your environment.

To setup apache on debian lenny, we need to create setup files on /etc/apache2/sites-enabled directory.

For port 80: /etc/apache2/sites-available/couch

<VirtualHost couch.example.org:80>
	ServerAdmin webmaster@example.org
	DocumentRoot /var/www/
	<Directory />
		Options FollowSymLinks
		AllowOverride None
	</Directory>
	ErrorLog /var/log/apache2/error.log
	LogLevel warn
	CustomLog /var/log/apache2/access.log combined
<IfModule mod_alias.c>
        Redirect permanent / https://couch.example.org/
</IfModule>
</VirtualHost>

For port 443: /etc/apache2/sites-available/couch-ssl

<IfModule mod_ssl.c>
<VirtualHost couch.example.org:443>
	ServerAdmin webmaster@example.org
	DocumentRoot /var/www/
	<Directory />
		Options FollowSymLinks
		AllowOverride None
	</Directory>
	ErrorLog /var/log/apache2/error.log
	LogLevel warn
	CustomLog /var/log/apache2/ssl_access.log combined
	SSLEngine on
	SSLCertificateFile    /etc/ssl/certs/ssl-cert-couch.pem
	SSLCertificateKeyFile /etc/ssl/private/ssl-key-couch.pem
	BrowserMatch ".*MSIE.*" \
		nokeepalive ssl-unclean-shutdown \
		downgrade-1.0 force-response-1.0
        <Location />
           AuthType Digest
           AuthName "CouchDB"
           AuthDigestDomain /
           AuthDigestProvider file
           AuthUserFile /etc/apache2/htdigest.db
           Require valid-user
        </Location>
        <IfModule mod_proxy.c>
           ProxyPass / http://127.0.0.1:5984/
           ProxyPassReverse / http://127.0.0.1:5984/
        </IfModule>
</VirtualHost>
</IfModule>

To use above settings, please change that following values and files for your environment.

  • VirtualHost couch.example.org:80
  • Redirect permanent / https://couch.example.org/
  • VirtualHost couch.example.org:443
  • SSLCertificateFile /etc/ssl/certs/ssl-cert-couch.pem
  • SSLCertificateKeyFile /etc/ssl/private/ssl-key-couch.pem
  • AuthUserFile /etc/apache2/htdigest.db

To enable changes, create symbolic-links and restart apache.

$ sudo a2ensite couch
$ sudo a2ensite couch-ssl
$ sudo /etc/init.d/apache2 restart

Set up CouchDB

Possible parameters and settings are explained at the top of this document. This section explains much more details.

require_authentication_db_entry

If it's true, the authenticated username should be described on the authentication_db, such as /_users/org.couchdb.user:username.

If it's the default value, false, the authenticated user can access to the couchdb without an authentication_db entry. In this case, the role of the user set to empty, []. To enable the role, user's authentication_db entry is essential.

webproxy_use_secret

If it's true and there is no X-Auth-CouchDB-Token line at the http request header, then the authorization will be failed.

To add the X-Auth-CouchDB-Token to the request header, the following settings are required.

Modified /etc/apache2/sites-available/couch-ssl

<IfModule mod_proxy.c>
        <IfModule mod_headers.c>
            RequestHeader add X-Auth-CouchDB-Token "c21ec459f6a650dcf6907f2b52e611a069a7aeee"
        </IfModule>
        ProxyPass / http://127.0.0.1:5984/
        ProxyPassReverse / http://127.0.0.1:5984/
</IfModule>

The value of X-Auth-CouchDB-Token can be calculated by SHA1 HMAC as following;

$ erl -pa /usr/local/lib/couchdb/erlang/lib/couch-1.0.1/ebin
1> nl(couch_util).
2> nl(crypto).
3> crypto:start().
4> Secret = <<"329435e5e66be809a656af105f42401e">>.
5> couch_util:to_hex(crypto:sha_mac(Secret,Secret)).
"c21ec459f6a650dcf6907f2b52e611a069a7aeee"

The value of 'Secret' is the value of the secret key on the .ini file.

Security considerations

The default value of the webproxy_use_secret is false.

In this case, if an user connects to couchdb's port directly, such as curl http://127.0.0.1:5984/, with a dummy header, like 'Authorization: Digest username="admin"', then the user will get the admin user's priviledge.

$ curl -H 'Authorization: Digest username="admin"' http://localhost:5984/_session

Please consider the webproxy_use_secret to be enable, but it's a little bit difficult, I guess. So that the default value is false to relax.

Example of a curl command line

If the ssl cert file was confirmed by the self-signed CA, then the cacert.pem file should be append to the curl command line.

$ curl --digest --cacert cacert.pem -u admin:xxxxxx https://couch.example.org/_session

Enjoy!

CouchDB: ApacheをReverse Proxyサーバにしてみた、完成版

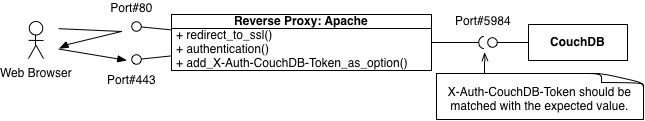
ApacheをReverse Proxyにすると、SSL化や認証についてApacheに関する情報がそのまま流用できて便利だよね、と思い認証ハンドラを作成しました。 とりあえず自分が使うのに必要なものを作って、一般化するために最低限の機能だけを加えています。

CouchDB Wikiにある Apache_As_a_Reverse_Proxyの手順でも似たようなことはできますが、null_authentication_handlerを使う事で、localhostのユーザは無制限にadmin権限を手に入れることができてしまいます。

これはReverse Proxy ServerとCouchDBを別のサーバで動かす場合に、気をつけなければならない点です。

この認証ハンドラは強固なセキュリティを提供するものではありませんが、いくらかリスクを軽減する事ができるはずです。

最終的に仕上げたCouchDB 1.0.1用のパッチは、新しいハンドラを追加しただけで、既存の機能は変更していないので、内部的な変更がなければ基本的には他のバージョンでも動くはずです。

この認証ハンドラは AlexにDebian lennyを入れた環境で試しています。 Erlang-R14BとCouchDB-1.0.1は手動でコンパイルしました。

セットアップ手順

~/20101127.1.couchdb101.webproxy.diffを準備して、CouchDB-1.0.1をコンパイルしたディレクトリに移動します。

$ cd apache-couchdb-1.0.1
$ patch -p1 < ~/20101127.1.couchdb101.webproxy.diff
$ cd src/couchdb
$ make
$ sudo cp couch_httpd_auth.beam /usr/local/lib/couchdb/erlang/lib/couch-1.0.1/ebin/

local.iniなどのiniファイルで認証にwebproxy_authentication_handlerを使用するようにします。

local.iniに追加する設定

[httpd]
authentication_handlers = {couch_httpd_auth, webproxy_authentication_handler}

この認証ハンドラは2つのオプションを取ります。

  • require_authentication_db_entry (default: true) - trueの場合、authentication_dbにユーザ名に対応したエントリがない場合、認証に失敗します
  • webproxy_use_secret (default:false) - trueの場合、Reverse Proxyが適切なX-Auth-CouchDB-Tokenヘッダを付与しない場合、認証に失敗します

これらを加えた一般的なこの認証ハンドラを使う場合の設定は次のようになります。

一般的なlocal.iniファイル

[httpd]
WWW-Authenticate = Basic realm="administrator"
authentication_handlers = {couch_httpd_auth, webproxy_authentication_handler}

[couch_httpd_auth]
require_valid_user = true
require_authentication_db_entry = true
webproxy_use_secret = false
secret = 329435e5e66be809a656af105f42401e

Reverse Proxy側の設定 (Apache)

Debianでは/etc/apache2/sites-enabledディレクトリに置いた設定ファイルをhttpdが認識します。 まずは/etc/apache2/sites-enabledにファイルを作成します。

Port 80用設定ファイル: /etc/apache2/sites-available/couch

<VirtualHost couch.example.org:80>
	ServerAdmin webmaster@example.org
	DocumentRoot /var/www/
	<Directory />
		Options FollowSymLinks
		AllowOverride None
	</Directory>
	ErrorLog /var/log/apache2/error.log
	LogLevel warn
	CustomLog /var/log/apache2/access.log combined
<IfModule mod_alias.c>
        Redirect permanent / https://couch.example.org/
</IfModule>
</VirtualHost>

Port 443用設定ファイル: /etc/apache2/sites-available/couch-ssl

<IfModule mod_ssl.c>
<VirtualHost couch.example.org:443>
	ServerAdmin webmaster@example.org
	DocumentRoot /var/www/
	<Directory />
		Options FollowSymLinks
		AllowOverride None
	</Directory>
	ErrorLog /var/log/apache2/error.log
	LogLevel warn
	CustomLog /var/log/apache2/ssl_access.log combined
	SSLEngine on
	SSLCertificateFile    /etc/ssl/certs/ssl-cert-couch.pem
	SSLCertificateKeyFile /etc/ssl/private/ssl-key-couch.pem
	BrowserMatch ".*MSIE.*" \
		nokeepalive ssl-unclean-shutdown \
		downgrade-1.0 force-response-1.0
        <Location />
           AuthType Digest
           AuthName "CouchDB"
           AuthDigestDomain /
           AuthDigestProvider file
           AuthUserFile /etc/apache2/htdigest.db
           Require valid-user
        </Location>
        <IfModule mod_proxy.c>
           ProxyPass / http://127.0.0.1:5984/
           ProxyPassReverse / http://127.0.0.1:5984/
        </IfModule>
</VirtualHost>
</IfModule>

サーバ名やファイル名など、具体的には次の内容が適切か確認してください。

  • VirtualHost couch.example.org:80
  • Redirect permanent / https://couch.example.org/
  • VirtualHost couch.example.org:443
  • SSLCertificateFile /etc/ssl/certs/ssl-cert-couch.pem
  • SSLCertificateKeyFile /etc/ssl/private/ssl-key-couch.pem
  • AuthUserFile /etc/apache2/htdigest.db

ファイル名を指定して、a2ensiteコマンドで設定を有効にします。

$ sudo a2ensite couch
$ sudo a2ensite couch-ssl
$ sudo /etc/init.d/apache2 restart

CouchDB側の設定

設定自体は冒頭に説明しましたが、その内容について解説します。

require_authentication_db_entryについて

trueの場合、authenticate_db(default: '_users')にユーザ名(example: username)に対応する文書(example: /_users/org.couchdb.user:username)がない場合、認証に失敗します。

require_authentication_db_entryを"false"にすると対応する文書がなくてもアクセス可能となります。 その場合は文書があればroleが設定され、なければroleは空"[]"になります。

webproxy_use_secretについて

trueの場合、HTTP Request Headerに適切なX-Auth-CouchDB-Token行がない場合、認証に失敗します。

変更したIfModule mod_proxy.cの内容

<IfModule mod_proxy.c>
        <IfModule mod_headers.c>
            RequestHeader add X-Auth-CouchDB-Token "c21ec459f6a650dcf6907f2b52e611a069a7aeee"
        </IfModule>
        ProxyPass / http://127.0.0.1:5984/
        ProxyPassReverse / http://127.0.0.1:5984/
</IfModule>

X-Auth-CouchDB-Tokenに指定する値はSHA1のHMACで、計算方法は 以前に投稿したように、salt = 329435e5e66be809a656af105f42401eとして次の手順で行ないます。

$ erl -pa /usr/local/lib/couchdb/erlang/lib/couch-1.0.1/ebin
1> nl(couch_util).
2> nl(crypto).
3> crypto:start().
4> Secret = <<"329435e5e66be809a656af105f42401e">>.
5> couch_util:to_hex(crypto:sha_mac(Secret,Secret)).
"c21ec459f6a650dcf6907f2b52e611a069a7aeee"

webproxy_use_secretがデフォルトのままfalseの場合、ローカルユーザがdummyのAuthorization行を追加した場合に、認証に成功してしまいます。

$ curl -H 'Authorization: Digest username="admin"' http://localhost:5984/_session

セキュリティの観点から設定をお勧めしますが、設定が少し難しいので、デフォルトの値をfalseとしています。

CouchDBは使えるのが基本ですからね。

couchdbをリスタートして設定を反映させます。

$ sudo /etc/init.d/couchdb restart

稼働確認

SSLに自己認証CA局を使っている場合は、そのcacert.pemファイルを指定して他のホストから次のようなリクエストを投げてみます。

$ curl --digest --cacert cacert.pem -u admin:xxxxxx https://couch.example.org/_session