ラベル ruby の投稿を表示しています。 すべての投稿を表示

2012/07/25

Ubuntu 12.04 LTSでmrubyを試してみた

組み込み用途に特化した軽量版Rubyの実装として、mrubyがリリースされています。

これの使いどころを考えてみたのですが、Tech-Onのインタビュー記事では、一例としてC言語で記述が難しい処理をmrubyにオフロードするとありました。

個人的には静的なコードはC言語で書くだろうと考えていて、動的なランタイムの変更をmrubyでユーザーに開放するんだろうなと思っています。 具体的には設定ファイルの記述やプラグインをmrubyスクリプトで作成することになるでしょう。

この使い方だけならluaなんかでも良いんですが、操作可能な要素をクラス単位でまとめる事ができるのは、実際のところ名前空間があるかどうかの違いぐらいしかありませんが、実用上の使い勝手は表面的な違い以上のものがあると感じています。

まぁ、ここら辺はいまのところ信念の問題なのですが、今回はmrubyを使って設定要素をクラスにまとめる場合を想定して、ちょっとしたサンプルを作ってみる事にしました。

テストした環境とmrubyのバージョンは次のようになっています。 特定のmrubyのバージョンには依存していないと思いますが、Webで調べたコードの中の関数の引数の取り方が違うものもあったので、念のため書いておきます。

  • OS: Ubuntu 12.04 LTS x86_64版
  • コンパイラ: gcc 4.6.3
  • mruby git commit: 8b6f6faf1e3771c04a1e2a58b1bbc84fe7d5c1e2

ちなみに、commit:のハッシュを使って、このテストしたmrubyと同じソースコードをbranch名"20120723.083824"で入手するには次のようにします。

$ git clone https://github.com/mruby/mruby.git
$ git checkout -b 20120723.083824 8b6f6faf1e3771c04a1e2a58b1bbc84fe7d5c1e2

mrubyのバージョンや日付によってメソッドの呼び出しシグネチャが違う事がありますが、だいたいそのまま読めると思います。

参考資料

参考にしたのは、主に手探りでおぼえるmruby その1:クラスを定義する、メソッドを定義するで、RICOHの方がまとめた記事もありましたがコードがGPLだったりするので、考え方などを参考にするに留めています。

とりあえずmrubyについては使い方よりも、生み出された背景や、中間コンパイラとしての挙動について、mrbcコマンドの動きを抑えておくのがお勧めです。

実証実験に参加した各種企業が公開しているドキュメントが参考になるでしょう。

mrubyのサイズ

x86_64環境でライブラリをenv COMPILE_MODE=release makeで作成すると、libmruby.a, libmruby_core.aの各ファイルはそれぞれ790KB前後のサイズになります。(strip後は470KB前後)

ruby-1.9.3-p194のコードをビルドすると、librucy-static.aのサイズはstrip後も2.1MBほどになります。

ライブラリの全てのシンボルとリンクする分けでもないので、静的にリンクした実行ファイルのサイズはもっと小さくなるはずですですが、CRubyのライブラリサイズの大きさは少し大き過ぎるなぁと感じるところです。

mrubyに求める機能

既に説明していますが、アプリケーションが提供するクラスを主体として、そのオブジェクトを組み込みメソッドを組み合せて操作できるところがメリットだろうと思っています。

普通のアプリケーションでは設定ファイルに固定文字列しか書けないのが普通ですが、これはセキュアだとは思うものの、記述できる語彙が少な過ぎるとも感じています。

luaはちょっとローレベルに過ぎる印象があってオブジェクト的に構造体の中に値と操作用関数をまとめる事はできますが、その環境をセットアップするのは少し面倒な印象です。

今回のゴール

mrubyを通してユーザーは日時情報や外部ファイルに記述されている内容などの情報に応じて振舞いを変化させる事ができるようになるといいなぁというわけですが、サンプルなので今回の範囲は一組のsetter/getterをラップしてみようと思います。

具体的に何をするのか、図にしてみた

図にしてみると次のようなプログラムを作成してみる事になります。
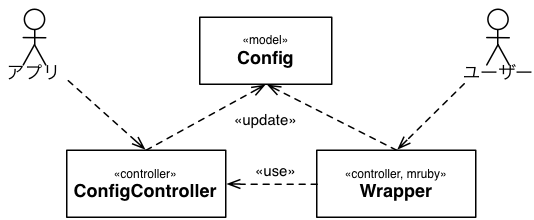
C言語レベルではConfigクラスに相当する設定可能な要素を構造体で定義します。

アプリからは直接構造体を操作せず、操作用のsetter/getterメソッドをConfigControllerクラスとしてまとめています。mrubyからはWrapperクラスを通してConfigControllerファイルでまとめているメソッドにアクセスしています。

実際のコード

いろいろ大風呂敷を広げましたが、ここから先はしょぼいコードが並びます。

ただGoogleで検索にヒットしたページは、やはりmrubyにコードをオフロードする仕組みやmrbcを使って中間コードを実行する方法に特化していたりしたので、もうちょっと泥くさい使い方を考えてみました。

conf.h, conf.c

実際にはConfとConfControllerに相当する機能はconf.c, conf.hにまとめました。 でも何かするわけではなくて、デバッグモードかどうかを動的に切り替えられるというだけです。

内容にはまったく意味がないんですが、気にしないでください。

conf.hファイル

#ifndef YA_CONF_H
#define YA_CONF_H 1

#include <mruby.h>

struct _conf {
  int is_debug;
} conf;

int is_debug(void);
void set_is_debug(int d);

#endif

conf.cファイル

#include "conf.h"
int is_debug(void) {
  return conf.is_debug;
}
void set_is_debug(int d) {
  conf.is_debug = d;
}
wrapper.h, wrapper.c

wrapper.hファイル

#ifndef YA_WRAP_H
#define YA_WRAP_H 1

#include <mruby.h>

struct RClass* yamrb_class;

mrb_state* yamrb_init(void);
mrb_value yamrb_is_debug(mrb_state* mrb, mrb_value self);
mrb_value yamrb_is_debug_equal(mrb_state* mrb, mrb_value self);

#endif

wrapper.cファイル

#include "conf.h"
#include "wrapper.h"

#include <mruby.h>
#include <mruby/numeric.h>

mrb_state* yamrb_init() {
  mrb_state* mrb = mrb_open();
  yamrb_class = mrb_define_class(mrb, "YaConf", mrb->object_class);
  mrb_define_method(mrb, yamrb_class, "is_debug", yamrb_is_debug, ARGS_NONE());
  mrb_define_method(mrb, yamrb_class, "is_debug=", yamrb_is_debug_equal, ARGS_REQ(1));

  return mrb;
}

mrb_value yamrb_is_debug(mrb_state* mrb, mrb_value self) {
  mrb_value ret = mrb_fixnum_value(is_debug());
  return ret;
}

mrb_value yamrb_is_debug_equal(mrb_state* mrb, mrb_value self) {
  mrb_int arg_debug;
  int argc = mrb_get_args(mrb, "i", &arg_debug);
  if(argc == 1) {
    set_is_debug(arg_debug);
  }
  return self;
}
main.c
#include <stdio.h>
#include "conf.h"
#include "wrapper.h"
#include <mruby.h>
#include <mruby/proc.h>
#include <mruby/compile.h>

mrb_state *mrb;
int gen_code_num;
mrbc_context *mrbc_ctx;

void init() {
  mrb = yamrb_init();
  FILE *fp = fopen("main.rb","r");
  mrbc_ctx = mrbc_context_new(mrb);
  struct mrb_parser_state* st = mrb_parse_file(mrb, fp, mrbc_ctx);
  fclose(fp);
  gen_code_num = mrb_generate_code(mrb, st->tree);
  mrb_pool_close(st->pool);
}

int main(int argc, char** argv) {
  init();
  
  // first run
  printf("current is_debug: %d\n", is_debug());
  mrb_run(mrb, mrb_proc_new(mrb, mrb->irep[gen_code_num]), mrb_nil_value());

  printf("current is_debug: %d\n", is_debug());
  set_is_debug(1);
  printf("new is_debug: %d\n", is_debug());

  // second run
  mrb_run(mrb, mrb_proc_new(mrb, mrb->irep[gen_code_num]), mrb_nil_value());

  // close
  mrbc_context_free(mrb, mrbc_ctx);
  mrb_close(mrb);
}

main.rb

print "-- begin --\n"
y = YaConf.new()
p y.is_debug()
y.is_debug = 2
p y.is_debug()
print "----\n"

Makefileファイル

INC = ./src/include
LIB = ./src/lib

main: conf.o wrapper.o main.c
	gcc -std=gnu99 -I. -I$(INC) -o main main.c conf.o wrapper.o -L$(LIB) -lmruby -lm

conf.o:	conf.c conf.h
	gcc -std=gnu99 -I. -I$(INC) -c conf.c 

wrapper.o: wrapper.c wrapper.h
	gcc -std=gnu99 -I. -I$(INC) -c wrapper.c 

気になったこと

Rubyの拡張ライブラリの知識は、いろんな意味で役に立ちますが、README.EXT.jaに対応するまとまったドキュメントがないので、いろいろ混乱するかもしれません。

FIX2INTなどの型変換マクロがない

Rubyの拡張ライブラリでは標準的なC言語の型との変換はマクロで実現していましたが、 mruby.hでは静的な関数が準備されています。

  • static mrb_value mrb_fixnum_value(mrb_int)
  • static mrb_value mrb_float_value(mrb_float)
  • などなど

mrb_intは標準のint型とtypedefされているだけで、直接に代入できます。 mrb_floatはmrbconf.hで定義されていますが、手元では8byteで通常はdouble型に紐付くようです。 文字列はmruby/string.hに定義されているような、組み込みString型用の関数を使う事になります。

mruby.hに定義されていなければ、操作対象の型に応じてmruby/以下のヘッダーファイルを眺める事になります。

mrb_generate_code()が返すint型の番号を管理する方法が欲しい

これはmrubyが準備する話しではないのですが、今回は処理が単純なのでmrbも全体で共有するような作りにしました。少し複雑になってきても、必要な都度、必要なコードをmrb_run()で呼びますが、この場合には対象のコードをmrb_generate_code()の戻り値で指定する必要がでてきます。

この管理方法が、まぁ対象のアプリに依りますが、どうなるかなぁと思っているところです。

まとめ

rubyはいろいろ機能が増えすぎて特定のバージョンとコードを密接に管理する必要があるので、mrubyはシンプルに保って欲しいなぁと思っています。まぁコンパイル時のオプションで調整することもできる部分もありますが。

C言語でアプリを組む時に機能の一部をオフロードする目的だと内蔵クラスや機能が多い方が楽になるわけですが、アプリケーションのプラグイン的にユーザーに開放する場合には、むしろ機能や組み込みクラスはないぐらいの方がセキュアになります。

mrubyは現状ミニマムで、これからスタンダード、フルといった主にクラスが追加される形のバージョンが出てくる事になっています。 とはいえ、ミニマムしかない現状でアプリの拡張をmrubyで行なおうとすると物足りない印象はあるので、前倒しでミニマウなmrubyが拡張されるような可能もあるのかなぁと思っています。 クラスセットについては、決まっているようですけれど、環境としてはまだまだ機能の追加が続いていますしね。

どうなるか、まだよくわかりませんが、アプリのコアエンジンとして安定してくれるといいなぁと思います。

2012/04/17

データベースに格納されている画像データをWebページに表示する

これまでWebアプリケーションを作る際のサムネイルデータなど、サイズのごく限られた画像ファイルをBLOBデータとしてデータベースに格納してきました。こういったケースは比較的よくあると思います。 最近では比較的大きなサイズの画像ファイルでもBLOBとして格納してしまうかもしれません。

今回は比較的サイズの小さな画像データをWebページに大量に貼り付けたい場合のお話しです。

背景

これまでは、DB上にあってファイルとしてアクセスできない画像を表示するために、画像データのストリームを返す小さなWebアプリケーションを準備してきました。

これだと画像ファイルの数が多くなった場合には、画像のデータ分だけのコネクションが必要になります。 keep-aliveが使えて実際のコネクション数が参照数と同じではないとしても、同一ページに小さな画像を大量に表示する事 は全体のパフォーマンス上の懸念材料になってきました。

いままでのベストプラクティスであれば、1ページは30kbyte以下に抑えるとか、画像データの取り扱いについてもいろいろありましたが、デスクトップアプリケーションの代りとしてWebアプリを作る場合には、これまでのルールが当てはまらない場合もでてきました。

HTMLに画像データを埋め込む技術的な話し

これまでの手法だとimgタグのsrc属性に画像表示用のURLを指定してidなどで画像を指定するようにしてきましたが、直接に画像データを指定します。

データを埋め込む例

<img src="data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAAHgAAABLCAIAAAA06NSGAAAACXBIWXMAAABI
AAAASABGyWs+AAAACXZwQWcAAAB4AAAASwDhLqRrAAAki0lEQVR42u18a5Bc
..." />

いままで試したプログラミング言語毎の例を載せておきます。

RubyでBase64を扱う方法

いま手元にあるのはRuby 1.9.3-p125ですが、方法は共通のはずで、だいたい次のようなコードになっています。

Base64の文字列を得るのにpackを使っています。

rubyでのイメージファイルのbase64化


## この例ではオリジナルデータをファイルにしています
@filepath = "/somewhere/foo.jpg"

@prefix = "data:$MIME_TYPE;base64,"

## この戻り値をimgタグのsrc属性に指定します。
def getSrcData(data)
  ret = @prefix.sub("$MIME_TYPE", getMimeType())
  ret += [IO.read(@filepath)].pack("m")
  return ret
end

def getMimeType()
  ext = File.extname(@filepath).downcase.sub("\.","")
  ext = "jpeg" if ext =~ /jpg/i
  return format "image/%s", ext
end
JavascriptでBase64を扱う方法

以前、Google Chromeの機能拡張でExifの情報を扱うアプリケーションを作成しました。 Chromeでは同じ機能拡張の中でもメインのタブとポップアップウィンドウの間ではデータ参照が制限されているので、メインコンテンツの画像を機能拡張のポップアップウィンドウの中で表示するには、外部参照のURLを渡すか、データ列を渡すかの方法をとることになります。

その時はExifを解析するためにメインコンテンツ側でダウンロードしたデータをBase64で渡して、ポップアップウィンドウ側に表示させました。これはダウンロード回数を最小にするべきだろうという理由での判断でした。

Javascript自身にはbase64化の手段がないので、Masanao Izumoさんが公開されているbase64.jsを利用しました。

Javascriptでのbase64化


  imgtag_data_list.push("data:image/jpeg;base64,"+base64encode(EXIF.getRawData(node)));

この時はいくつかbase64化のライブラリを試しましたがテキストではなく、バイナリに対応しているのはIzumoさんのコードしか見つけられませんでした。コード中のEXIF.getRawData(node)で参照しているデータはXMLHttpRequestのresponseBodyです。

考慮点

同じ画像を大量に表示するような場合は、テキストファイルに埋め込むよりも、アプリケーション側でLast-ModifiedCache-Controlヘッダーをちゃんと扱うようにするのが最も経済的です。

安易にCGIやらで組むと動的アプリケーションの特性としてCache-Control: no-cache付く事になるので、キャッシュが有効になりませんが、これに気をつけるだけでブラウザが適切に繰り返しの読み込みを効率化してくれます。

他には画像データのサイズが比較的大きい場合は、HTMLファイルのダウンロードに時間がかかる事になるので、最初の画面描画が遅くなる欠点があります。ここ最近のブラウザはレンダリング途中から表示が始まるので、問題にならないかもしれませんが、いずれにしろサイズの大きなファイルを大量に表示するのは、もともとの設計に問題があります。

画像データの埋め込みはあくまでもサムネイルや、HTMLメールなどの用途に限定するべきでしょう。 よくよく考えて使わないと、策に溺れる事になります。

2012/04/15

pubimg: 画像ファイルを外部に公開するためのユーティリティ

このブログのコンテンツ自身はテキストファイルで、独自にXMLスキーマをRelaxNGを使って定義して、Emacsのnxmlモードでバリデーションしながら書いています。

外部参照用のURLは外部のXML定義ファイルにまとめていて、コアの機能は固まっていますが、ラベル一覧やURL一覧に効率良くアクセスする手段は模索中だったりします。

ブログだけでなく外部に公開する画像ファイルを対象に、効率良くアップロードするためのユーティティを作成しました。

pubimg本体の動き

外部に画像ファイルを公開する時に必要な作業の流れは次のようになっています。

  • サイズなどを整えた画像ファイルを作成
  • 手元のPCのあるディレクトリにファイルをコピー
  • Apache AntのFtpTaskでバッチ的にファイルをアップロード

この時にブログなどの記事を書く方では、最終的なURLの形式が必要になるので、ファイルを登録するとURLを表示するようにしています。 ここら辺はホームディレクトリの~/.pubimg.confプロパティファイルを参照して、コピー先やURLのprefixの情報等をApache AntとRubyの両方で共有しています。

このプログラムで実行している様子は次の通りです。

端末でpubimgを実行した様子

pubimgスクリプトの特徴

このスクリプトは単純ですが、次のような機能を持っています。

  • コピー先のファイル名を別に指定
  • 日付情報をprefixに付与
  • ファイルサフィックス(いわゆる拡張子)をコピー元から自動的に判別
  • sha256チェックサムで同じファイルが存在した場合には、コピーせずに既にアップロードされているURLを表示

たとえば gnome-screenshot を使った場合は、ファイル名が "Screenshot-1.png"のような名前がデフォルトになります。公開用に作成した分けではない画像ファイルであれば、オリジナルから名前を変更することが必要になります。

そこでpubimgは、第2引数にコピー先のファイル名を指定して、次のような使い方ができます。

$ pubimg Screenshot-4.png terminal_exec_pubimg
http://www.yasundial.org/images/pubimg/20120415.0.terminal_exec_pubimg.png

内容が異なるファイルを既にあるURLにコピーしようとした場合は、日付後のindexがインクリメントします。

$ pubimg Screenshot-5.png terminal_exec_pubimg
http://www.yasundial.org/images/pubimg/20120415.1.terminal_exec_pubimg.png

うっかりヒストリにあるコマンドを実行したり、別の名前で登録しようとしても、重複して登録される事はありません。

$ pubimg Screenshot-4.png hogehgoe
http://www.yasundial.org/images/pubimg/20120415.0.terminal_exec_pubimg.png

プロパティファイル

Apache antとRubyで共有しているプロパティファイルの内容は次のようになります。

プロパティファイル

local.dir = ${user.home}/.pubimg/files
remote.dir = /images/pubimg/.

ant.home = ${user.home}/java/tools/ant
java.home = /usr/java/1.6.0

url.prefix = www.yasundial.org/images/pubimg/

Apache AntのFtpTask用の設定ファイルは別の場所にあり、プロパティで指定する事もできるようになっています。

もし複数のftpアップロード先が必要になれば、読み込むプロパティファイルを切り替える仕組みをpubimg側に入れるだけです。

さいごに

これだけだとライブラリ管理はできていないので、ファイルのリストや削除は別のアプリケーションを作成する事にします。また将来的にはWindowsからファイルをアップロードしたいので、pubimgの機能はRESTアプリケーションとしても動く事になるでしょう。

pubimg自身は複数の小さいrubyクラスから出来ているのでREST側からその機能を呼ぶのは難しくないはずです。どちらかというと権限管理とか、RESTサーバーアプリからファイルを直接コピーさせるわけにもいかないので、そういう手間が増えそうな予感はします。

自宅用のアプリだし、セキュリティの懸念を考慮しなくていいならすぐに動くかな…。

Ruby 1.9.3でfirebirdクライアントを使ってみた

FireBirdはファイルベースで扱えるのでFast-CGIなどで組む場合には非常に便利です。 SQLite3の機能では型が不足していたり、ストアドプロシージャーを使いたい場合などには良い代替案になると思います。

xstowで管理しているrubyのバージョンを1.9.3-p125に更新してから、firebirdに接続するためにfbパッケージをgemから導入しようとしたところエラーが発生しました。

Gitから最新版を入手しましたが、1.9.2で非推奨となっていたSTR2CSTRが本格的に使えなくなったので、コードを書き換えたのでログを残しておきます。

Githubからのコードの取得

作業環境がUbuntu 10.04 LTSなので、gitコマンドを使って作業領域にfbディレクトリを作成します。

$ git clone https://github.com/wishdev/fb.git
$ cd fb
$ ruby extconf.rb
$ make

ここでとりあえずコンパイラは通りますが、make installをしてrubyからDBを作成しようとするとエラーが出て作業を続ける事ができなくなります。

ここはfb.cからSTR2CSTRマクロを使っている個所を一括置換で修正しました。 そうすると今度は沢山あったワーニングの中にエラーが1つ増えて、途中でコンパイルが終了してしまいます。

コンパイル時のエラー

Githubからfbの最新版を取得して、STR2CSTRをStringValuePtrに機械的に置き換えてコンパイルしましたが、次のようなエラーが表示されました。

STR2CSTRをStringValuePtrに書き換えた後のコンパイルエラー

fb.c:2185: error: lvalue required as unary ‘&’ operand

解決策

ここのコードは以前でもSafeStringValueを通すべきなんじゃないかなと思いましたが、 STR2CSTRの他に、以下のような修正を1個所で行なえばruby 1.9.3でfirebirdが使えるようになります。

エラー発生個所の変更前のコード


    sql = StringValuePtr(rb_ary_shift(args));

エラー発生個所の変更後のコード


    VALUE r_sql = rb_ary_shift(args);
    SafeStringValue(r_sql);
    sql = StringValuePtr(r_sql);

2011/03/24

RubyでFastCGIとGetTextモジュールを組み合せる

Rubyで多言語化を行なうにはMutohさんのRuby-GetText-Packageが便利そうです。

通常の po → mo の変換を行なえばメッセージを m17n できるところが良いので、作業の内容は一般的なものです。

単純な置換なら手でも作れますが、将来的に複数の言語に対応するなら、自分でロジックを組む手間が削減できます。

処理速度が速くなるかどうかは微妙で、ステータスをThread毎に格納して、全体のメッセージ文はRuntimeでキャッシュされるので手作業で置換ロジックを書くよりも多少はスピードアップが期待できそうです。ただメモリを消費してもよいならシンプルに正規表現のリストと置換する文字列の対を作った方が早いんじゃなかろうかと想像しています。

ERBだと<%= _("message") %>のように埋め込む手間がかかり、可読性は多少低下するデメリットもありそうです。

それでもGetTextモジュールを使うことで作業手順が標準化できるので、置換対象の文字列を管理する後々のメンテナンスを考えると総合的に利点が上回ると思います。

GetText自体はcgiクラスとの組み合せを想定しているので、FastCGIについてはドキュメントがなさそうでした。 そのためGetTextとFastCGIについてまとめておきます。

開発環境について

いつものようにUbuntu 10.04 LTS x86_64版を使用しています。

  • OS: Ubuntu 10.04 LTS x86_64
  • Ruby 1.9.2-p136 (/usr/local/bin/ruby) + gettext + fcgi
  • Apache 2.2.14 + libapache2-mod-fcgid

FastCGIとCGIの違い

FastCGIは標準添付ライブラリにはないため、fcgiモジュールをgemなどでインストールする必要があります。

CGIとの違いは起動済みのプロセスにWebブラウザからアクセスする仕組みなので、プロセスの起動にかかる時間が短縮される分、メモリを常に使いますが処理スピードは速いです。

またプロセス自体は終了せずに(Rubyの場合)スレッドが各ブラウザからのリクエストを処理するため、インスタンス変数やクラス変数を適切に使うことで、キャッシュの効果により全体的なレスポンスを向上させる事もできます。

その反面、処理する単位はオブジェクト単位にしてシンプルに切り分けないと、キャッシュしたくない内容が残ったりしてプライバシー上の問題を引き起す可能性もあります。

一般的なWebコンテンツのホスティングサービスでは、FastCGIのようにプロセスが常駐するとメモリを消費するため、必要に応じてリソースを消費するCGIやPHPが一般的です。

FastCGIもCGIもWebの初期からある仕組みなので古典的に扱われますが、Web以前から起動済みのプロセスにオンライントランザクションを処理させる仕組みは、決済やら問い合せ処理やらを高速に処理する仕組みとしてよく知られていました。

起動時間とその起動処理を無視できることは、アクセスが増えていく中で安定的なレスポンスを得るための重要な要件の一つです。

PHPはApacheのモジュールとしてサーバのプロセスイメージの中で処理が完結するため速いはずですが、基本的にはあらかじめ処理内容をキャッシュするわけではないので、時間は短縮できますが、接続毎にいろいろな初期化処理が必要となる点が独特です。

さて「FastCGIは古くない!」という主張は十分したので、GetTextとの組み合せについてまとめます。

FastCGIとGetTextの組み合せ

GetText付属のサンプルをみると、CGIモジュールに対応したスクリプトがありますが、そのままではFastCGIに適用できません。

その理由はFastCGIのスレッドをプールして使い回すという性質にあります。

違いを説明する前に雛型になりそうなスクリプトは次のようになります。

完全に動作するFastCGIスクリプト全体

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-

$:.unshift "/app/lib"
ENV['GEM_HOME'] = "/app/gems"

require 'rubygems'
require 'fcgi'
require 'cgi'
require 'erb'
require 'gettext/cgi'
require 'gettext/tools/parser/erb'

## Render
class SimpleRender

  def initialize(query, env)
    @query = query
    @env = env
    Locale::clear
    Locale::set_request([query["lang"]], [], env["HTTP_ACCEPT_LANGUAGE"], env["HTTP_ACCEPT_CHARSET"])
    GetText::set_output_charset("UTF-8")
    GetText::bindtextdomain("sample", "/app/data/locale")
  end
  
  def render
    ret = ""
    content = "/app/sample.erb"

    ret += ERB.new(open(content, "r:utf-8").read).result(binding)
    return ret
  end

  def _(msgid)
    GetText::_(msgid)
  end
end

## Controller
class Main
  def initialize(request)
    @env = request.env
    @query = check_query_string(CGI.parse(@env['QUERY_STRING']))
  end
  
  def run
    ret = "Content-Type: text/html; charset=UTF-8\r\n\r\n"
    case @query["mode"]
    when "search"
      sr = SimpleRender.new(@query, @env)
      ret += sr.render()
    end
    return ret
  end

  private
  def check_query_string(q)
    ret = {}
    label = "mode"
    ret[label] = (q.has_key?(label) and not q[label][0].empty?) ? q[label][0] : "search"
    label = "lang"
    ret[label] = (q.has_key?(label) and not q[label][0].empty?) ? q[label][0] : "ja"
    return ret
  end
end

###############
## main loop ##
###############

FCGI.each {|request|
  main = Main.new(request)
  request.out.print main.run
  request.finish
}

スクリプトが参照している外部ファイルについて

gemsを使うかどうかは問題ではないのですが、requireしているモジュール・ライブラリにアクセスできるように、先頭の6行は適切なパスに書き直す必要があります。

/app/sample.erbはコンテンツ本体で、次のような内容になっています。

sample.erb本体

<html>
<body>
<h1><%= _("Hello World") %></h1>
</body>
</html>

GetTextモジュールの処理の中心となる翻訳データを保存するためには /app/data/localeディレクトリを作成しています。 作成方法はmoファイルを生成するところで行なっています。

結果として、ライブラリを除いた/appディレクトリの構造は次のようになっています。

$ find . -type f
./po/en/sample.po
./po/ja/sample.po
./po/sample.pot
./Rakefile
./data/locale/en/LC_MESSAGES/sample.mo
./data/locale/ja/LC_MESSAGES/sample.mo
./sample.erb
解説:Thread毎のキャッシュの破棄

LocaleはThread.current[:current_request]に必要なデータ構造をキャッシュします。

スレッドが消滅しないかもしれないので、接続毎に処理が終った段階でデータを破棄する必要があります。

処理が終った段階」を徹底するために、処理を始める前にデータを破棄しています。 このLocale::clearはnilを代入するだけの処理なので、スレッドが立ち上がった最初に実行しても問題ない内容になっています。

処理開始時にLocale::clearを呼び出しているところ

    Locale::clear
    Locale::set_request([query["lang"]], [], env["HTTP_ACCEPT_LANGUAGE"], env["HTTP_ACCEPT_CHARSET"])
    GetText::set_output_charset("UTF-8")
    GetText::bindtextdomain("sample", "/app/data/locale")
解説:クライアントの言語情報の登録

前項にあるコードの2行目 Locale::set_request()メソッド が、クライアントが利用する言語を登録しているところです。

CGIモジュールを使うサンプルでは、Locale::set_cgi()を使用していますが、今回はCGIオブジェクトは使えないため直接その内部で使用している Locale::set_requestメソッド を呼び出しています。

第一引数に指定した言語から優先度が高く、第二引数にはCookieに保存した言語情報を格納する想定ですが、cookieを使っていないので空にしています。

GetText関連ファイル(po,moファイル)の作成

今回の例では、moファイルにアクセスするために、/app/data/localeを指定しています。

必要なファイルを作成するために、まず次のような内容の/app/Rakefileファイルを作成しました。 これはMutohさんのページの説明ほぼそのままです。

/app/Rakefileの全体

$:.unshift "/app/lib"

desc "Update pot/po files."
task :updatepo do
  require 'gettext/tools'
  GetText.update_pofiles("sample", Dir.glob("*.erb"), "sample 1.0.0")
end

desc "Create mo-files"
task :makemo do
  require 'gettext/tools'
  GetText.create_mofiles
end

先頭の $:.unshift は、FastCGIスクリプトと同じで、GetTextモジュール(gettext.rb)へのパスです。

デフォルトのパスにインストールしていれば不要ですが、今回は特別な場所にモジュールを配置しているので追加しています。

ファイルを配置した後は、poファイルを作成します。

$ cd /app
$ rake updatepo

"/app/po/sample.pot"が作成されるので、それを言語毎のディレクトリにコピーをして翻訳を行ないます。

$ cd /app
$ mkdir po/ja po/en
$ cp po/sample.pot po/ja/sample.po
$ cp po/sample.pot po/en/sample.po

2つのsample.poの翻訳が終ったら moファイル を作成します。

$ rake makemo

これが無事に終ると /app/data/locale/ja/LC_MESSAGES/sample.mo/app/data/locale/en/LC_MESSAGES/sample.mo のファイルが作成されているはずです。

po/ja/sample.poファイルの内容

# Copyright (C) 2011 Yasuhiro ABE yasu@yasundial.org
#
#, fuzzy
msgid ""
msgstr ""
"Project-Id-Version: sample 1.0.0\n"
"POT-Creation-Date: 2011-03-24 09:25+0900\n"
"PO-Revision-Date: 2011-03-24 09:25+0900\n"
"Last-Translator: FULL NAME <EMAIL@ADDRESS>\n"
"Language-Team: LANGUAGE <LL@li.org>\n"
"MIME-Version: 1.0\n"
"Content-Type: text/plain; charset=UTF-8\n"
"Content-Transfer-Encoding: 8bit\n"
"Plural-Forms: nplurals=INTEGER; plural=EXPRESSION;\n"

#: sample.erb:3
msgid "Hello World"
msgstr "こんにちは"

FastCGIスクリプトの実行

Apacheを適切に設定して、Options ExecCGIが設定された場所に配置してWebブラウザから呼び出します。

URLの最後に ?lang=ja?lang=enをつけて呼び出して内容が変化することを確認します。

GetTextモジュールを使っていて気がついたこと

rmsgmergeコマンドが使えない

たぶん一斉置換か何かの影響か、gettext/tools/rmsgmerge.rb の中がおかしくなっています。

rmsgmergeの修正個所

#      refpot = parser.parse_file(config.refstrrefstr, PoData.new, false)
      refpot = parser.parse_file(config.refpot, PoData.new, false)

これで終りかと思いきや、-hで表示される第一引数と第二引数は逆にしないといけない模様です。

いまのところRakefileの方が便利そうなので困ってはいませんが、コマンドを使って更新をpoファイルに反映したい場合には注意が必要です。

困った事にdebパッケージでruby 1.8.x用に入っているrmsgmergeも動きません。

rgettextコマンド内部で参照しているrgettext.rbへのパスがおかしい

require 'gettext/rgettext'require 'gettext/tools/rgettext'に変更しました。

rgettextコマンド内部にあるrubyコマンドへのパスを変更する

rmsgmergeでも同じでしたが、コマンドの先頭にある#! /usr/bin/rubyのパスを#!/usr/local/bin/rubyに変更しました。

$:変数にライブラリディレクトリを加える

またRuby 1.9.2では$:はカレントディレクトリを指さないので、gettext.rbのあるディレクトリへのパスを$:に登録しています。

いろいろ修正したrgettextスクリプト全体

#! /usr/local/bin/ruby
# -*- coding: utf-8 -*-
=begin
  rgettext - ruby version of xgettext

  Copyright (C) 2005-2009  Masao Mutoh
  
  You may redistribute it and/or modify it under the same
  license terms as Ruby.

=end

$:.unshift File::join([File::dirname($0),"..","lib"])

begin
  require 'gettext/tools/rgettext'
rescue LoadError
  begin
    require 'rubygems'
    require 'gettext/tools/rgettext'
  rescue LoadError
    raise 'Ruby-GetText-Package are not installed.'
  end
end

GetText.rgettext

ドキュメントが微妙に古くて通用しない記述もいろいろありましたが、ちゃんと動いています。

m17n のためには、gettextの標準的な作法が使えるというのは強力だと思います。

2011/03/11

DB2 Express-C 9.7とRuby(IBM_DB Driver)を使ってみる

最近はNonSQL DBばかりに注力していたので、ひさしぶりにRDBMSに回帰してみました。

データは最近扱っているiptablesログか郵便番号か、どちらにしようかと思ったのですが、MongoDBでは郵便番号情報を扱っていたので、今回はRubyを使って郵便番号DBを作成しています。

さいしょに感想らしきものを一言

MongoDBとCouchDBの比較はいろいろありますが、DB2を使ってみて改めて感じるのはチューニングポイントが沢山あって使いこなすマニアックな喜びはありそうだという点です。

けれど、ACIDがなくてもOptimisticな処理で十分対応できる用途に対しては、RDBMSを導入する利点よりもメンテナンスコストが上回ってしまう気がします。

あと、DB2と関係ないですが、MongoDBが物理メモリをかなり消費する点も気になっています。 本体の消費メモリは少ないはずですが、memmapを使ってファイルにアクセスしているようです。

CouchDBが動いているErlangのbeamプロセスは負荷をかけてもだいたい30MB前後、MongoDBは物理メモリの搭載量にも依存するようですが、できるだけ空き領域をキャッシュとして使うようにみえます。

DB2は比較にならないほどのプロセス数とスレッド数とメモリを消費してくれますが、NODEディレクトリにある物理ファイルのサイズはMongoDBよりも小さいです。

もっともMongoDBは使うファイルを最初に領域を確保してしまいますから、db.stats()で表示されるdataSizeをみると純粋なデータサイズはかなり小さくですけどね。

今回は ibm_db ライブラリを使って、Ruby から DB2 CLI Driver を呼び出しています。

オフィシャルのibm_db API documentだけでは役に立たない模様で、DeveloperWorksの参考書を読まないと何がなんだかさっぱりでした。

環境の説明

今回は次のような環境で作業を行ないました。

  • CPU: PhenomII 940 X4
  • Memory: 8GB (FileCache: 約4GB)
  • Disks: 500GBx2 (Software RAID-1)
  • DB2 Express-C 9.7 (db2leve: DB2 v9.7.0.2)
  • Ruby: 1.9.2-p136
  • Ruby CLI Driver: IBM_DB 2.5.6

Ruby CLI Driverの導入

gemを使ってダウンロードしますが、gemsの仕組みは使わないので、ibm_dbのlibディレクトリだけコピーしてきます。

$ export IBM_DB_LIB=~/sqllib/lib
$ export IBM_DB_INCLUDE=~/sqllib/include
$ gem install --install-dir tmp_rubylib ibm_db
$ cp -r tmp_rubylib/gems/ibm_db-2.5.6/lib .

ここから先はコピーしたlibディレクトリのあるディレクトリで作業を行ないます。

DBの作成とテーブルの定義

Databaseの作成は最初にちょっとするだけなので、手動でやっておきます。

$ db2 create db postaldb using codeset UTF-8 territory en

しばらくはリモート接続をしないので、nodeの作成やらDB2COMMの設定などはしないでおきます。

次はテーブルを作成します。 分割はせずに一つの巨大なテーブルを作成しています。

POSTALテーブル作成スクリプト

#!/bin/bash

db2 'connect to postaldb'
db2 'DROP TABLE POSTAL'
db2 'CREATE TABLE POSTAL ( SERNUM INTEGER PRIMARY KEY NOT NULL, CITYID  INTEGER, PCODEOLD  CHAR(6), PCODE CHAR(8), PREFKANA  GRAPHIC(7), CITYKANA  GRAPHIC(25), STREETKANA  GRAPHIC(70), PREF  GRAPHIC(7), CITY  GRAPHIC(25), STREET  GRAPHIC(70), OP0  INTEGER, OP1  INTEGER, OP2  INTEGER, OP3  INTEGER, OP4  INTEGER, OP5  INTEGER )' 
db2 'terminate'

preparedステートメントを使ったデータのINSERT

Rubyを使ったINSERT文の使い方はドキュメントになくて、executeUpdateに相当するメソッドもないようなので、普通にexecuteメソッドを使いました。

ken_all.utf8.csvファイルをPOSTALテーブルにINSERTするRubyスクリプト (insert_csv_prepare.rb)

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-

require 'csv'

$:.unshift "lib"
require 'ibm_db'

conn = IBM_DB::connect("postaldb","","")
IBM_DB::autocommit(conn, IBM_DB::SQL_AUTOCOMMIT_ON)

sql = "INSERT INTO POSTAL (SERNUM,CITYID,PCODEOLD,PCODE,PREFKANA,CITYKANA,STREETKANA,PREF,CITY,STREET,OP0,OP1,OP2,OP3,OP4,OP5) VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?,?,?,?)"
pstmt = IBM_DB::prepare(conn,sql)
sernum = 1
opts={}
opts[:headers] = [:i,:pcode_old,:pcode,:pref_kana,:city_kana,:street_kana,:pref,:city,:street,:op0,:op1,:op2,:op3,:op4,:op5]
CSV.new(open("ken_all.utf8.csv"), opts).each do |row|
  IBM_DB::execute(pstmt, [sernum.to_i, row[:i].to_i,
                          row[:pcode_old], row[:pcode], row[:pref_kana],row[:city_kana],row[:street_kana],row[:pref],row[:city],row[:street],row[:op0].to_i,row[:op1].to_i,row[:op2].to_i,row[:op3].to_i,row[:op4].to_i,row[:op5].to_i])
  sernum += 1
end

IBM_DB::close(conn)

このスクリプトを準備するために、郵便局のWebサイトから郵便番号データをダウンロードしておきます。

$ unzip ken_all.zip
$ nkf -w ken_all.csv > ken_all.utf8.csv
$ ruby insert_csv_prepare.rb

約12万件(元データ約17MB)分のテーブルを作成するのに、2分30秒ほどかかりました。 Prepared statement(プリペアード・ステートメント)を使わずにSQLを毎回生成すると、7分30秒ほどでしたから、だいたい処理効率は3倍くらい違いがあります。

パフォーマンスについて

MongoDBでもDISTINCT(PREF),PREFKANAの結果を47行出力させてみましたが、MongoDBではPREFに対するINDEXがかなりパフォーマンスに寄与しました。

DB2でINDEXを作成せずにSQLを投げると、だいたいdb2start直後で接続時間を省いて3秒前後くらいです。 2回目以降はキャッシュが効くのか、0.2秒くらいになりました。

DB2のINDEXを使ってどうなるのか。 いろいろ謎なパラメータが沢山あるので、使い方によってはマッチしないんじゃないかなという心配がありました。

そんな理由で調査にはdb2advisが便利そうだったので、EXPLAIN表を作ってからSQLを実行して、DB2に最適なINDEXを考えさせました。

$ db2 connect to postaldb
$ db2 -tvf /opt/ibm/db2/V9.7.2/misc/EXPLAIN.DDL
$ db2advis -d postaldb -s "select distinct(pref),prefkana from postal"
-- LIST OF RECOMMENDED INDEXES
-- ===========================
-- index[1],    0.771MB
   CREATE INDEX "YASU    "."IDX1103110446310" ON "YASU    "."POSTAL"
   ("PREFKANA" ASC, "PREF" ASC) ALLOW REVERSE SCANS COLLECT SAMPLED DETAILED STATISTICS;
   COMMIT WORK ;

おなじことをしてみた結果は、予想どおり、この程度のデータ量ではあまり変化はなく、むしろDB2の接続にかかる時間が全体のパフォーマンスを低下させています。

RubyスクリプトでMongDBとDB2で同じような結果になるようにして時間を計測しましたが、MongoDBはdistinctしたPREFに対応するPREFKANA列を別に検索するカーソルの1ページ分の結果をprefetchするロジック的には効率は低いはずです。 また、結果はそれぞれ数回実行した後のものを載せています。

MongoDB | 2.182[s] (index無。接続時間含む)
MongoDB | 0.282[s] (index有。接続時間含む)
DB2     | 3.225[s] (index無。connect時間含)
DB2     | 1.751[s] (index有。connect時間含)
DB2     | 0.164[s] (index無。connect済)
DB2     | 0.121[s] (index有。connect済)

当たり前の結果ですが、DB2を使うならDBPoolingの仕組みは大切だということになりそうです。

SELECT文を発行するRubyスクリプトはprepared statementを利用する必要はありませんが、参考までにprepared state版を載せておきます。

SELECTを行なうSQL文 ibm_db driver/prepared statement版 (select_distinct_pref_pstmt.rb)

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-

$:.unshift "lib"
require 'ibm_db'

conn = IBM_DB::connect("postaldb","","")
IBM_DB::autocommit(conn, IBM_DB::SQL_AUTOCOMMIT_ON)

sql = "SELECT DISTINCT(PREF),PREFKANA FROM POSTAL"
pstmt = IBM_DB::prepare(conn,sql)
if IBM_DB::execute(pstmt, [])
  while row = IBM_DB::fetch_array(pstmt)
    puts "#{row[0].strip},#{row[1].strip}."
  end
end

IBM_DB::close(conn)

2011/02/26

Ruby::ゾンビプロセスを量産するopenメソッドの使い方 - IO::popenと%x{}の違い

DTIサーバのディスク容量監視にyadaemon.rbを使ったRubyスクリプトを走らせています。

ディスク容量を把握するのは、ちょっと面倒なので内部では手を抜いてopen("|df")を実行しています。

しばらく走らせてみたらdefunctプロセス(いわゆるゾンビプロセス)が大量発生したので、その原因を考えてみました。

問題のあったコード

"df"プロセスが終了していなかったのは次の部分です。

問題のあるコード部分抜粋

module YaWatchDisks
  def yield_df_perms
    open("|df ").each_line do |line|
      #       "Filesystem"  "1K-blocks"    "Used"    "Available" "Use%" "Mounted on"
      # perms: ["/dev/md0", "484041584", "453132936", "6514352", "99%", "/"]
      perms = line.split(/\s+/)
      yield perms if perms.length == 6 and perms[1].to_i > 0 and perms[2].to_i > 0 and perms[3].to_i > 0
    end
  end
...

考えてみれば、each_lineメソッドを実行する主体はeach_lineメソッドのブロックを終了してからcloseメソッドを呼び出すなんていう責任はないわけです。

内部ではopen("|df")の部分がGCの対象になるまで常に滞留していたはずです。

でも実際にはGCの対象にもならず、元プロセスは常駐していますから、プロセスが大量に残っていたという事になります。

問題の修正

変に省略せずに、ブロックをつけて呼び出してあげれば、何の問題もなくcloseされるようになります。

修正したコード部分抜粋

module YaWatchDisks
  def yield_df_perms
    open("|df ") do |f|
      f.each_line do |line|
        #       "Filesystem"  "1K-blocks"    "Used"    "Available" "Use%" "Mounted on"
        # perms: ["/dev/md0", "484041584", "453132936", "6514352", "99%", "/"]
        perms = line.split(/\s+/)
        yield perms if perms.length == 6 and perms[1].to_i > 0 and perms[2].to_i > 0 and perms[3].to_i > 0
      end
    end
  end
...

しばらくしてからmuninで確認すると、プロセス数が純増していたグラフからzombie分が消えていて解決したことが確認できました。

ruby-forum.comで見つけた理由らしきもの

Googleでドキュメントを検索していたらhttp://www.ruby-forum.com/topic/62435で、外部プログラムの結果を得るなら「バッククォートや%x{}構文を使ったら?」という記述がありました。

これを、試してみると古いコードでも確かにゾンビプロセスは発生しなくなり、問題なく動くようになりました。

2011/02/22

Ruby 1.9.2以降(移行後?) - YAML::unescapeの行方

作成しているアプリケーションの中で設定を変更するために、YAMLデータ形式を経由してsave/restore機能を付けています。

便利に使っていたのですが、やや本気で使ってみたところ、UTF-8な日本語文字列をファイルに書き出したタイミングでエスケープされた形式になってしまう事に気がつきました。

YAML形式でファイルを書き出すsave_yamlモジュールメソッド

  def save_yaml(file, hash)
    require 'syck/encoding'
    open(file, "w") do |f|
      f.write(YAML::dump(hash))
      f.flush
    end
  end
  module_function :save_yaml

次のように、出力の一部は人間が読み書きできる形式ではなくなっています。

...
title: "\xE3\x83\x97\xE3\x83..."
...

日本語に限らずヨーロッパ系言語も1バイトに収まらないものはあるので、困っている人は他にも居たようで、調べてみるとYAML::unescape()を使う workaround をみつけました。→ Ruby to_yaml utf8 string

しかしRuby 1.9.2移行はYAML関連のパッケージが syck.rb にまとめられてしまったので、モジュール名がSyckになっています。

結局はSyck::unescapeを使う事で無事に解決しました。

変更後のモジュールメソッド

  def save_yaml(file, hash)
    require 'syck/encoding'
    open(file, "w") do |f|
      f.write(Syck::unescape(YAML::dump(hash)))
      f.flush
    end
  end
  module_function :save_yaml

2011/01/14

Rubyでのflockの使い方

マニュアルでflockの使い方をみると、File::RDWR|File::CREATを指定していて、"w"を使うと切り詰め(truncate)るからダメだという記述があります。

ruby-1.9.2-p0/file.cに記載されているflockのサンプル

 *     # update a counter using write lock
 *     # don't use "w" because it truncates the file before lock.
 *     File.open("counter", File::RDWR|File::CREAT, 0644) {|f|
 *       f.flock(File::LOCK_EX)
 *       value = f.read.to_i + 1
 *       f.rewind
 *       f.write("#{value}\n")
 *       f.flush
 *       f.truncate(f.pos)
 *     }

たしかに"w"はだめだろうけど"r+"か"w+"ならいけるんじゃなかろうかと思って調べてみました。

ソースコードに記述された各モード文字列の意味

手元にあったruby-1.9.2-p0のio.cをみると、次のような記述があります。

ruby-1.9.2-p0/io.cからの抜粋 (9755-9773行)

 *    Mode |  Meaning
 *    -----+--------------------------------------------------------
 *    "r"  |  Read-only, starts at beginning of file  (default mode).
 *    -----+--------------------------------------------------------
 *    "r+" |  Read-write, starts at beginning of file.
 *    -----+--------------------------------------------------------
 *    "w"  |  Write-only, truncates existing file
 *         |  to zero length or creates a new file for writing.
 *    -----+--------------------------------------------------------
 *    "w+" |  Read-write, truncates existing file to zero length
 *         |  or creates a new file for reading and writing.
 *    -----+--------------------------------------------------------
 *    "a"  |  Write-only, starts at end of file if file exists,
 *         |  otherwise creates a new file for writing.
 *    -----+--------------------------------------------------------
 *    "a+" |  Read-write, starts at end of file if file exists,
 *         |  otherwise creates a new file for reading and
 *         |  writing.
 *    -----+--------------------------------------------------------

"w"や"w+"を使っていると、もしロックに失敗してもファイルの内容が失なわれてしまいます。 もっともLOCK_NBを加えていないサンプルのコードの場合には、ずっと待つので関係ない気がします。

そこでサンプルを考えてみました。2つのスクリプトがtest00.txtというファイルに自分のファイル名を書き込もうとします。

最初に実行するtest00a.rb

#!/usr/local/bin/ruby
#-*- coding: utf-8 -*-
@basedir = File::dirname($0)
file = File::join([@basedir,"test00.txt"])
File.open(file, "w", 0644) {|f|
  f.flock(File::LOCK_EX)
  f.rewind
  f.write($0)
  f.flush
sleep 10
  f.truncate(f.pos)
}

次に実行するtest00b.rb

#!/usr/local/bin/ruby
#-*- coding: utf-8 -*-
@basedir = File::dirname($0)
file = File::join([@basedir,"test00.txt"])
File.open(file, "w", 0644) {|f|
  if f.flock(File::LOCK_EX)
    f.rewind
    f.write($0)
    f.flush
    f.truncate(f.pos)
  end
}

別端末でcat test00.txtをループしながら、スクリプトを実行すると2つめの"test00b.rb"を実行した時点で処理が一時停止したかのようにみえます。

$ while true ; do cat test00.txt ; sleep 1 ;done

...
./test00a.rb
./test00a.rb
./test00a.rb  ## ← test00b.rbの実行直後から、内容のないファイルをcatするため画面には何も表示されない
./test00b.rb  ## ← seep 10の処理が終り、ファイルが上書きされ、その内容が出力される
./test00b.rb
./test00b.rb
...

とはいえ、確実にflockで待機していたtest00b.rbが内容を上書きしているので、意図したような動き自体にはなっているはずです。

ここでLOCK_NBを一緒に使う場合を考えると、実際にはファイルを上書きしなくてもファイルサイズが零になるため問題になるでしょう。

スクリプトを少し変更して、File::LOCK_NBを一緒に使うようなサンプルを作成してみます。

File::LOCK_NBを使った排他制御の例

前節と同様にtest01a.rb, test01b.rbを準備して、それぞれからtest01.txtを自身のファイル名で上書きする事を考えます。

ただし今回はファイルオープンに"r+"オプションを指定します。

最初に実行するtest01a.rb

#!/usr/local/bin/ruby
#-*- coding: utf-8 -*-
@basedir = File::dirname($0)
file = File::join([@basedir,"test01.txt"])
File.open(file, "r+", 0644) {|f|
  f.flock(File::LOCK_EX)
  f.rewind
  f.write($0)
  f.flush
sleep 30
  f.truncate(f.pos)
}

次に実行するtest01b.rb

#!/usr/local/bin/ruby
#-*- coding: utf-8 -*-
@basedir = File::dirname($0)
file = File::join([@basedir,"test01.txt"])
File.open(file, "r+", 0644) {|f|
  if f.flock(File::LOCK_EX|File::LOCK_NB)
    f.rewind
    f.write($0)
    f.flush
    f.truncate(f.pos)
  end
}

これで実行するとファイルの新規作成はできませんが、既存ファイルを準備しておけば期待通りに動きます。

さいごに

表に戻ると、C言語の最初にfopenを習った時は"r"やら"r+"やらのアクセスモードの違いがよく分かりませんでした。

でも確認すればいいんですよね。ただ、経験がない分、それをどういう場面で使えばいいかの想像力が少し十分ではなかったかな。

教えるっていう行為は経験値が足りない人にどう伝えればいいかの部分が難しいんですよね、きっと。

2011/01/09

CouchDB: Viewでのkeyの並び順(Order)の確認レシピ

CouchDBでViewを作成して、startkeyendkeyで条件を指定する時に、優先順位がいまいち分かりずらいので検証するための環境を作ってみました。

あらかじめ準備しておくものは次のものです。

  • CouchDB本体 (今回は1.0.1を準備しました)
  • Ruby (今回はjsonライブラリが用意されているRuby1.9を使います。Ruby 1.8を使用する場合にはjsonライブラリを別途御準備ください。curlでの代用も可能ですが、十分な注意が必要です)
  • テスト文書作成用DB (今回は"example"を使用しますが、任意の名前で結構です)

併わせて参考のために本家のCouchDB Wiki - View_collationを確認すると良いでしょう。

とりあえず結論

結果だけを知りたいという方のために、最初に今回の結果を載せておきます。

とりあえず"id"は無視して、keyの右辺の並びを上から順に眺めてください。

/example/_design/order/_view/orderの表示結果

{"id"=>"ordercheck.12", "key"=>nil, "value"=>nil}
{"id"=>"ordercheck.2", "key"=>false, "value"=>nil}
{"id"=>"ordercheck.4", "key"=>true, "value"=>nil}
{"id"=>"ordercheck.14", "key"=>-1, "value"=>nil}
{"id"=>"ordercheck.5", "key"=>1, "value"=>nil}
{"id"=>"ordercheck.3", "key"=>10, "value"=>nil}
{"id"=>"ordercheck.11", "key"=>"", "value"=>nil}
{"id"=>"ordercheck.0", "key"=>"a", "value"=>nil}
{"id"=>"ordercheck.15", "key"=>"bcd", "value"=>nil}
{"id"=>"ordercheck.10", "key"=>"z", "value"=>nil}
{"id"=>"ordercheck.13", "key"=>"\uFFF0", "value"=>nil}
{"id"=>"ordercheck.6", "key"=>[0, 1], "value"=>nil}
{"id"=>"ordercheck.9", "key"=>[0, 3, 2], "value"=>nil}
{"id"=>"ordercheck.7", "key"=>[1], "value"=>nil}
{"id"=>"ordercheck.8", "key"=>[1, nil, ""], "value"=>nil}
{"id"=>"ordercheck.16", "key"=>[1, 2], "value"=>nil}
{"id"=>"ordercheck.1", "key"=>{}, "value"=>nil}

nilからfalse,trueの順に並んでいく様子がわかります。

nil → 真偽値(false→true) → 数値 → 文字列 → 配列 → ハッシュ

配列の場合は基本的に先頭から要素の有無でまずソートされ、その次に要素の値でソートされています。 要素の数は重要ではない事がわかります。

この配列の扱いは個人的にViewの定義を考える時に混乱するところですが、Viewがちゃんとソートされていればlimit, skipを使って部分的な結果を得て、そのままWebページなりエンドユーザに出力することが出来るので便利なはずです。

作業の流れ

今回はCouchDB内に実際に文書とViewを作成します。その結果を表示する事で、どういった順序でソートされるのかを確認します。

作成する文書

文書の構造は次の通りです。

{
  "_id":"check_order.11",
  "_rev":"1-77356980318a930bb8afc1e6193fa981",
  "k":""
}

"k"に真偽値やら数値やらを代入していきます。

Map関数

"k"をキーにしています。Reduce関数は定義していません。

function(doc) {
  if(doc._id.indexOf('check_order.') == 0) {
    emit(doc.k, null);
  }
}
作成したViewの表示

最終的には最初に載せたような結果が得られ、優先順位は次のようになっている事がわかります。

nil → 真偽値(false→true) → 数値 → 文字列 → 配列 → ハッシュ

今回はこういう結果を出力するスクリプトを準備しておいて、どういう並び順になるか確認するための環境を作ります。

スクリプトの準備

流れに従って、文書作成用のスクリプトを作成する前にCouchモジュールに対するWrapperモジュールを作成しておきます。

ディレクトリ・ファイル構造

今回は"test"ディレクトリをトップディレクトリとして、相対的にlib, initdb, viewsディレクトリを作成していきます。libディレクトリ名は固定で、各スクリプトから"../lib"にパスを通します。

"lib"ディレクトリと同じレベルに存在すれば、"initdb", "views"ディレクトリ名は任意の名前に変更できます。

  • test/lib … ライブラリディレクトリ ("lib"ディレクトリ名は変更不可)
  • test/lib/couchdb.rb … CouchDB Wikiに掲載されているCouchモジュール
  • test/lib/util.rb … Couchモジュールにエラー処理を追加したWrapperモジュール
  • test/initdb … 文書作成用ディレクトリ (ディレクトリ名は変更可)
  • test/initdb/init_docs.rb … 文書を作成するスクリプト
  • test/initdb/show_all_docs.rb … 作成されている文書を全て表示するスクリプト
  • test/initdb/remove_docs.rb … 任意の_idを持つ文書を削除するスクリプト
  • test/views … View作成用ディレクトリ (ディレクトリ名は変更可)
  • test/views/_design.views.order.rb … Viewを作成するスクリプト
  • test/views/show_views.rb … 作成したViewを表示するスクリプト
lib/util.rbの作成

require 'couchdb'で呼び出しているライブラリは、Couch Wikiの「Getting started with Ruby」に掲載されているCouchモジュールです。

先頭にあるDBNameには文書を作成するために使用する、作成済みDB名を'/'から始めて書いてください。

次にYaCouch::getCouchの中を適宜変更して、Couch::Serverクラスのインスタンスをcouchに代入できるようにオプションを適宜変更します。

util.rbファイル全体

# -*- coding: utf-8 -*-

require 'json'
require 'uri'
require 'couchdb'

module YaCouch
  DBname = '/example'
  def YaCouch::getCouch
    ## couch = Couch::Server.new('user'=>'admin', 'password'=>'')
    couch = YaCouch::Main::getCouchAsAdmin
    return YaCouch::Main.new(couch)
  end
  class Main
    require 'json'
    require 'uri'
    def initialize(couch = nil, debug = false)
      @couch = couch
      @debug = debug
    end
    def get(uri)
      json = Hash.new
      begin
        res = @couch.get(URI.escape(uri))
        json = JSON.parse(res.body)
      rescue
        p $! if @debug
      end
      json = Hash.new if json.has_key?("error")
      json
    end
    def put(uri, json)
      res = nil
      begin
        res = @couch.put(URI.escape(uri), json.to_json)
      rescue
        p $! if @debug
      end
      res
    end
    def post(uri, json)
      res = nil
      begin
        res = @couch.post(URI.escape(uri), json.to_json)
      rescue
        p $! if @debug
      end
      res
    end
    def delete(uri)
      res = nil
      begin
        res = @couch.delete(URI.escape(uri))
      rescue
        p $! if @debug
      end
      res
    end
  end
end
initdb/init_docs.rbの作成

文書名(_id)は、「"check_order." + 数字」にしていますが、何でも構いません。

init_docs.rbファイル全体

#!/usr/bin/env ruby

$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'

@couch = YaCouch::getCouch
@num = 0
def up(json_value)
  uri = YaCouch::DBname + '/check_order.' + @num.to_s
  json = @couch.get(uri)
  json["k"] = json_value
  res = @couch.put(uri, json)
  @num += 1
end

## prepare documents
up("a")
up(Hash.new)
up(false)
up(10)
up(true)
up(1)
up([0,1])
up([1])
up([1,nil,""])
up([0,3,2])
up("z")
up("")
up(nil)
up("\ufff0")
up(-1)
up([0,4])
up("bcd")
up([1,2])
views/_design.views.order.rbの作成

Viewを作成するポイントは "/example/_design/order" です。

_design.views.order.rbファイル全体

#!/usr/bin/env ruby

$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'

@couch = YaCouch::getCouch
uri = YaCouch::DBname + "/_design/order"
json = @couch.get(uri)
json['language'] = 'javascript'
json['views'] = Hash.new
json['views']['order'] = Hash.new
json['views']['order']['map'] = <<-MAP
function(doc) {
  if(doc._id.indexOf('check_order.') == 0) {
    emit(doc.k,null);
  }
}
MAP
res = @couch.put(uri,json)
p res.body
views/show_views.rb

show_views.rbファイル全体

#!/usr/local/bin/ruby

$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'
@couch = YaCouch::getCouch

uri = YaCouch::DBname + "/_design/order/_view/order"
json = @couch.get(uri)
json['rows'].each do |row|
  p row
end

このスクリプトの実行結果は、最初に掲載したようなdoc.kをキーとしてソートされた文書のリストになります。

まとめ

タイトルを「〜レシピ」にしたので、その体裁で書こうと思ったものの、挫折しました。

それはさておき、Rubyで使えるライブラリはいろいろありますが、手元の環境ではStunnel4を使い、CouchDBサーバはSSLクライアント認証を有効にしているため、接続部分をカスタマイズする必要があります。

テストのためにApacheのmod_proxyを使ってDigest認証での接続も出きるようにしていますが、いずれにしてもデフォルトの接続処理のセキュリティに満足していないので、低レベルなCouchモジュールに手を入れて使っています。

そんな事をしていないのであれば他のライブラリに慣れるのが良さそうですが、その場合でもこのスクリプトを大きく変更する必要はないと思います。

Appendix. 追加スクリプト

処理の本筋ではない、initdb/show_all_docs.rb と initdb/remove_docs.rb スクリプトを掲載しておきます。

initdb/show_all_docs.rb

show_all_docs.rbファイル全体

#!/usr/bin/env ruby

$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'
@couch = YaCouch::getCouch
uri = YaCouch::DBname + '/_all_docs?include_docs=true'
json = @couch.get(uri)
json['rows'].each do |row|
  p row['doc']
end
initdb/remove_docs.rb

引数無しに実行すると、内部でdelete_doc_prefix変数に設定されている"_id"名が"check_order."で始まる文書が削除されます。

View定義を削除する時には引数に "_design"を指定してください。

remove_docs.rbファイル全体

#!/usr/bin/env ruby
$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'util'

delete_doc_prefix ='check_order.'
delete_doc_prefix = ARGV[0] if ARGV.length == 1

@couch = YaCouch::getCouch
uri = YaCouch::DBname + '/_all_docs?include_docs=true'
json = @couch.get(uri)
json['rows'].each do |row|
  d = row['doc']
  if d['_id'] =~ /^#{delete_doc_prefix}/
    uri = format("%s/%s?rev=%s", YaCouch::DBname, d['_id'], d['_rev'])
    res = @couch.delete(uri)
    p res.body
  end
end

2010/12/20

Rubyアプリケーションでの設定ファイルのフォーマット

Jabberクライアントを作成した時の設定ファイルにJSON形式を使いましたが、少し後悔しています。

それはJSON形式では、最後の要素の後ろに','(カンマ)を置くとエラーになってしまうからです。

エンドユーザ向けの設定ファイルであれば、1行1命令であるべきで、各行相互の関係性を把握させるのは難しいと思います。

今回はそんなアプリケーションで利用する設定ファイルの書式について考えてみました。

手動で '=' で区切られた要素を分解し、Hashオブジェクトにする

テキストファイルで書ける設定ファイルは便利で、YAMLやJSONなどいくつか候補はあります。

しかし適当に '=' で区切った文字列を受領するような形式も手軽で使い易かったりします。

# filename: config.txt
jabber.name = Foo bar
jabber.pass = xxxxxx
jabber.server = jabber.org
...

これをHashに分解するコードはすぐに書けます。

=で区切られた設定ファイルを読み込み conf変数を準備する

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-
conf = Hash.new
open("config.txt","r:utf-8").each_line do |line|
  next if line.empty? or line =~ /^#|^$/
  key,value = line.split(/=/,2) 
  conf[key.strip] = value.strip
end
p conf
出力:
{"jabber.name"=>"Foo bar", "jabber.pass"=>"xxxxxx", "jabber.server"=>"jabber.org"}

この処理の中で受け付ける設定ファイル名だけを確認するなどすれば、エラーハンドリングも手軽でユーザにも優しいスクリプトになるでしょう。

Structクラスを使った設定ファイルを使用する

もう少し柔軟性が必要なら、設定できる項目を指定してstructを使う事もできます。

# -*- coding: utf-8 -*-
# filename: config.txt
@conf.name = '漢字の名前'
@conf.current_date = DateTime.now.ctime

@confオブジェクトに設定できる内容はStructによって制限する事ができます。

設定ファイルを読み込み @conf変数を書き換える

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-
Config = Struct.new(:name, :current_date)
@conf = Config.new
require 'date'
load 'config.txt'
p @conf
出力:
#<struct Config name="漢字の名前", pass="Mon Dec 20 15:48:46 2010">

スコープが異なるので、変数名は@で始まるインスタンス変数にする必要があります。

loadlの代りにrequireを使うこともできますが、ファイル名のサフィックスが".rb"である事や$:変数を適切に設定するなどの手続きが必要になることから、設定ファイルの読み込みにはloadが最適です。

また、この方法だとconfig.txtは完全なRubyスクリプトになるので、名前空間が汚染されるなど、一定の危険性はあります。

常に使える方法ではありませんが、もっと制御をユーザに開放したければDSL(Domain Specific Language)の手法が参考になるでしょう。

まとめ

YAML形式とかJSON形式はプログラマには便利で、アプリケーション同士がやりとりするにはデバッグ含めて最適だと思います。

一般ユーザに設定ファイルを書いてもらう場合には、検証と適切なエラーメッセージが出せるかどうかがポイントになります。

その点ではJSONパーサに処理をまかせてしまうよりは、手動で一行を読み込みsplitで分割する手法が案外役に立つ場面が多いでしょう。

RubyによるJabberクライアントの作成とパスワードの管理

普通のJabberクライアントをRubyで作成するためには、 xmpp4rライブラリを使って数行のコードで完結します。

今回は外部のサーバにコードを配置するので、少し要件を加える事にしました。

  • プログラマとパスワードを管理する人間は別であるという前提が存在する
  • JabberIDのパスワードはスクリプトに埋め込まない
  • パスワードが書かれたファイル単体が流出しても問題ないよう暗号化する
  • 各ファイルは別の名前に変更して使う事ができるようにする

さらにTest::Unitフレームワークでテストができるように、コードの共通部分はモジュール(module YaJabber)の中に埋め込んでいます。

ファイルの構造

今回はRuby 1.9.2で標準ライブラリに加わっている点を考えて、ファイルフォーマットにJSONを使用しました。

ディレクトリ構造は以下のとおりで、各ファイルへは相対パスでアクセスするようになっています。


  ./sendmsg2j.rb            ## コマンド本体
  conf/sec_config.json      ## デフォルトの共通鍵ファイル
  conf/config.json          ## デフォルトの設定ファイル
  conf/gmail_config.json    ## Gmail接続用見本
  conf/jabber_config.json   ## Jabber.org接続用見本
  lib/xmpp4r                ## jabberクライアント用ライブラリ
共通鍵ファイルの形式

暗号化に使用する共通鍵データファイル: sec_config.json

{
  "sec_text" : "5ee6f7e62b8b1de083bb2617738a4ade620f9c09"
}
接続用ID設定ファイルの形式

パスワードやJabberサーバへの接続情報は別ファイルとして扱っています

Jabberクライアントの接続情報 Gmail版: gmail_config.json

{
  "user_name":"xxxxx@gmail.com/Batch",
  "user_pass":"357150946dd3950f96af22f2f639bc4d",
  "user_salt":"4e6c13d4aac544b2",
  "server_name":"talk.google.com",
  "server_port":"5222",
  "remote_user":"xxxxx@gmail.com/Home",
  "msg_subject":"Post message from VPS"
}

Jabberクライアントの接続情報 Jabber.org版: jabber_config.json

{
  "user_name":"xxxxx@jabber.org/Batch",
  "user_pass":"fcf53684962bc19f273e5a7c9bad257f",
  "user_salt":"bf6123bf1e2c52b6",
  "server_name":"jabber.org",
  "server_port":"5222",
  "remote_user":"xxxxx@jabber.org/Home",
  "msg_subject":"Post message from VPS"
}

この2つの設定ファイルを送信したいIDによってコマンドオプションで設定ファイルを切り替えるか、デフォルトの設定ファイル config.json を上書きして使っています。

想定する使い方

初期化時のシナリオ

sec_config.jsonファイルの"sec_text" : の右辺を任意の文字列で上書きする。

{ "sec_text" :   "この中を任意の文字列で書き換える" }
パスワード設定/変更時のシナリオ
  • 新しいパスワードを準備する
  • ./sendmsg2j.rb -eを実行する
  • パスワードを入力し、出力された2行をconfig.jsonファイルの内容と差し替える
  • テスト用メッセージを送信する
メッセージの送信のシナリオ

送りたいメッセージは標準入力から読み込むので、コマンドの出力などをそのまま送信できます。

echo "message" | ./sendmsg2j.rb

外部ファイルからメッセージを読み込む場合はリダイレクトで行ないます。

./sendmsg2j.rb < message_file.txt
設定ファイルの変更方法

'-c'オプションを使って、別のID設定情報を使う。

echo "message" | ./sendmsg2j.rb -c conf/gmail_config.json
共通鍵ファイル名を変更したい

'-s'オプションを使って、別の共有鍵データファイルを使う。

echo "message" | ./sendmsg2j.rb -c conf/gmail_config.json

まとめ

Jabberクライアント自体はちゃんと動いているのと、オンラインでいるユーザにメッセージを送信する手段としてはおもしろいと思います。

重要な情報であればメールと組み合せれば、メールサーバの滞留などに対する回避策にもなるでしょう。

問題だと感じたのは、設定ファイルの形式です。 けれど、これは別の話なので記事を分けました。

Appendix. スクリプト本体

いろいろコードをいじったので無駄に焼け太った感じがあります。

module内部のメソッドは関数型言語のようなイメージですが、綺麗に切り取られた印象もなく、かなりごちゃごちゃしています。

パスワードファイルとの分離のためにこうなってしまっただけで、xmpp4rの使い方としては特別な事はしていないのでご注意ください。

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-
#
#= Yadiary Jabber Client Script
#
# This script assumes the following directory structures.
#
#   ./sendmsg2j.rb          ## main and module file
#   ./conf/sec_config.json  ## the '-s' option changes the file name.
#   ./conf/config.json      ## the '-c' option changes the file name.
#
# This is tested with talk.google.org and jabber.org servers.
#
#== Encryption mode
#
# Your jabber password should be encrypted this script at first.
#
#   ./sendmsg2j.rb -e [-s <sec_config.json>]
#
# After enter your password, then the script shows you 'user_pass' and 'user_salt' parameters.
# These parameters are copied to your 'config.json' file.
# The data structure of the 'config.json' file will be described later.
#
#== Send message mode
# The message body is read by the standard input stream by following command line.
#   ./sendmsg2j.rb [-s <sec_config.json>] [-c <config.json>]
#
# In practical use, you will use this script with following idioms.
#
# 1. ./sendmsg2j.rb [-s <sec_config.json>] [-c <config.json>] < message_file
# 2. echo message | ./sendmsg2j.rb [-s <sec_config.json>] [-c <config.json>]
#
# First case (#1), the 'message_file' contains the entire message body.
# Last case (#2), the 'message' string is your choice.
#
#== Unit Tests
# The 'unittest/test_sendmsg2j.rb' is the executable Test::Unit script file.
# It will test all methods except
#
#== 'sec_config.json file
# The 'sec_config.json' file contains the essential password string.
# It should have the following data structure.
#
#   { "sec_text" : ".. password string like sha1sum hash value ..." }
#
# You can change the filename and location by the '-s' option.
#
#== 'config.json file
# The 'config.json' file is the following data structure.
#   {
#     "user_name":"daemon@example.org/Batch",
#     "user_pass":"5208502be38983bbf6847c0f7554f7f7",
#     "user_salt":"63c9240d88705faf",
#     "server_name":"example.org",
#     "server_port":"5222",
#     "remote_user":"user01@example.org/Home",
#     "msg_subject":"post message from daemon@example.org/Batch"
#   }
# You can change the filename and location by the '-c' option.
#
$:.unshift File.dirname($0)
$:.unshift File.join([File.dirname($0),"lib"])
require 'optparse'
require 'xmpp4r'
require 'json'

# 
# This module is for Yadiary Jabber Client.
#
# These methods should be tested by the unittest/test_sendmsg2j.rb script.
module YaJabber
  
  # It should have the following data structure.
  #
  #   { "sec_text" : ".. password string like sha1sum hash value ..." }
  #
  SEC_CONFIG_FILE = File.join([File.dirname($0), "conf", "sec_config.json"])
  
  # The 'config.json' file is the following data structure.
  #   {
  #     "user_name":"daemon@example.org/Batch",
  #     "user_pass":"5208502be38983bbf6847c0f7554f7f7",
  #     "user_salt":"63c9240d88705faf",
  #     "server_name":"example.org",
  #     "server_port":"5222",
  #     "remote_user":"user01@example.org/Home",
  #     "msg_subject":"post message from daemon@example.org/Batch"
  #   }
  #
  CONFIG_FILE = File.join([File.dirname($0), "conf", "config.json"])
  
  # A wrapper method to read json file.
  #
  # Example:
  #   conf = json_read(SEC_CONFIG_FILE)
  #
  def json_read(file)
    conf = nil
    begin
      conf = JSON.parse(open(file).read)
    rescue
      conf = nil
    end
    return conf
  end
  
  #
  # Get your password string from the given json file.
  #
  # Example:
  #   pass = get_password(sec_conf_file)
  #
  def get_password(sec_conf_file)  # sec_conf_file - test
    conf = json_read(sec_conf_file)
    res = ""
    label = 'sec_text'
    res = conf[label] if conf.kind_of?(Hash) and conf.has_key?(label)
    return res
  end

  # 
  # Example:
  #   plain_text = STDIN.gets.strip
  #   enc_text,salt = encrypt(pass, plain_text)
  #
  def encrypt(pass, plain_text)
    begin
      salt = OpenSSL::Random.random_bytes(8)
      enc = OpenSSL::Cipher::Cipher.new('aes-256-cbc')
      enc.encrypt
      enc.pkcs5_keyivgen(pass.to_s, salt.to_s, 1)
      e_text = enc.update(plain_text) + enc.final
      return e_text.unpack("H*").join, salt.unpack("H*").join
    rescue
      p $!
      return "",""
    end
  end
  #
  # Example:
  #   user_rawpass = decrypt(pass, enc_text, salt)
  #
  def decrypt(pass, text, salt)
    begin
      n_salt = [salt].pack("H*")
      n_text = [text].pack("H*")
      enc = OpenSSL::Cipher::Cipher.new('aes-256-cbc')
      enc.decrypt
      enc.pkcs5_keyivgen(pass.to_s, n_salt.to_s, 1)
      return enc.update(n_text) + enc.final
    rescue
      p $!
      return ""
    end
  end
  
  #
  # It returns the existing filename.
  #
  # Example:
  #   begin
  #     @sec_conf_file = check_file(@option['sec_conf_file'], SEC_CONFIG_FILE)
  #   rescue
  #     printf("[error] security conf file '%s' not found.\n", @sec_conf_file)
  #     exit(1)
  #   end
  #
  def check_file(candidate_file=nil, default_file=nil)
    conf_file = candidate_file
    conf_file = default_file if conf_file == nil or not FileTest.exist?(conf_file)
    raise if not FileTest.exist?(conf_file)
    return conf_file
  end

  #
  # This is a domain specific method.
  # The 'conf' argument must be the CONFIG_FILE format.
  #
  def check_conf(conf={})
    ## remove empty value
    conf.reject! { |k,v|
      true if v == nil or v == ""
    }
    ## set the default value for optional parameters
    conf['server_name'] = "jabber.org" if not conf.has_key?('server_name')
    conf['server_port'] = "5222" if not conf.has_key?('server_port')
    conf['msg_subject'] = format("Messages from %s", conf['user_name']) if not conf.has_key?('msg_subject')
    ## check the config key/value pairs.
    if not conf.has_key?('user_name') or not conf.has_key?('user_pass') or 
        not conf.has_key?('user_salt') or not conf.has_key?('remote_user')
      return false ## means BAD
    end
    return true ## means GOOD
  end
  
  # parse command line options
  def option_parser
    res = { 
      "encrypt_mode" => false,
      "conf_file" => nil,
      "sec_conf_file" => nil
    }
    OptionParser.new do |opts|
      opts.banner = 'Usage: ' + File.basename($0) + '\tinput: read messages from stdin.'
      opts.separator ''
      opts.on('-e', '--encrypt', 'Interactive password encrypt mode') {
        res['encrypt_mode'] = true
      }
      opts.on('-c', '--config filename', 'Set a config file') do |c|
        res['conf_file'] = c if FileTest.exist?(c)
      end
      opts.on('-s', '--sec_config filename', 'Set a security config file') do |c|
        res['sec_conf_file'] = c if FileTest.exist?(c)
      end
      opts.on_tail('-h', '--help', 'Show this message') {
        puts opts
        exit
      }
      opts.parse!(ARGV)
    end
    return res
  end

  # aggreate method which will send a message.
  def send_message(user_name, user_pass, remote_user,msg_subject, server_name, server_port)
    client = Jabber::Client.new(Jabber::JID.new(user_name))
    client.connect(server_name, server_port)
    client.auth(user_pass)
    body = STDIN.readlines.join
    m = Jabber::Message.new(remote_user, body).set_type(:normal).set_id('1').set_subject(msg_subject)
    client.send(m)
    client.close
  end
end

##########
## main ##
##########
if $0 == __FILE__
  include YaJabber

  ###################################
  ## load encrypt/decrypt password ##
  ###################################
  @option = option_parser
  begin
    @sec_conf_file = check_file(@option['sec_conf_file'], SEC_CONFIG_FILE)
  rescue
    printf("[error] security conf file '%s' not found.\n", @sec_conf_file)
    exit(1)
  end
  @crypt_pass = get_password(@sec_conf_file)
  if @crypt_pass.empty?
    printf("[error] Your security config file, %s, doesn't have the 'sec_text' parameter or non-empty value.\n", @sec_conf_file)
    printf("  Please check your security config file.\n")
    exit(1)
  end
  
  #####################
  ## encryption mode ##
  #####################
  if @option['encrypt_mode']
    ## confirm the input
    print "** password encryption mode **\n"
    print "enter string: "
    line = STDIN.gets.strip
    if line.empty?
      print "Please enter the non-empty string as your password.\n"
      exit
    end

    ## ok, let's start.
    enc_text,salt = encrypt(@crypt_pass, line)
    if enc_text.empty? or salt.empty?
      printf(<<-EOF, @sec_conf_file)
  Please check your "sec_text" parameter in the security config json file, %s.
EOF
    else
      printf(<<-EOF, enc_text, salt)
  "user_pass":"%s",
  "user_salt":"%s",
exit.
EOF
    end
    exit
  end
  
  #################
  ## normal mode ##
  #################
  ## load config file
  begin
    @conf_file = check_file(@option['conf_file'], CONFIG_FILE)
  rescue
    printf("[error] conf file, %s, not found.\n", @conf_file)
    exit(1)
  end
  conf = json_read(@conf_file)
  
  if not check_conf(conf)
    printf(<<-EOF, @conf_file)
[error] Config key/value pairs are not enough to start.
The config file %s should have like following values.
{
  "user_name":"sysuser01@jabber.org/Batch",
  "user_pass":"19570e028a958d0cbc91add9c1516e05",
  "user_salt":"e42489150b1bed52",
  "remote_user":"user01@jabber.org/Home",
  "server_name":"jabber.org (option)",
  "server_port":"5222 (option)",
  "msg_subject":"System message from sysuser01@jabber.org/Batch. (option)"
}
EOF
    exit(1)
  end
  
  ##################
  ## send message ##
  ##################
  user_pass = decrypt(@crypt_pass, conf['user_pass'], conf['user_salt'])
  if user_pass.empty?
    printf("[error] Please check 'user_pass' or 'user_salt' fields on config file, %s\n", @conf_file)
    exit(1)
  end
  send_message(conf['user_name'], user_pass, conf['remote_user'],
               conf['msg_subject'], conf['server_name'], conf['server_port'])
end
#################
## end of main ##
#################

Test::Unitを考慮したRubyスクリプトの書き方

DTIのVPSサーバからの連絡をjabber.orgに作ったアカウントで受けるために、RubyでJabberクライアントを作成しました。

単一のRubyスクリプトでクライアントを作成しましたが、その時に少し要件を加えてコードのボリュームが膨らんだので、RubyのTest::Unitフレームワークを使ってテストケースを作成しました。

RubyでTest::Unitを使う場合に、クラス/モジュールファイルにテスト用のコードを加える方法はよくみますが、今回は単体コマンドとしてのスクリプト側にモジュールを寄せて、単体テスト用のコードは別ファイルにしています。

今回使ったRubyのバージョンは1.9.2-p0です。

なおRuby 1.9.xからは単体テスト環境として附属するのはminitestモジュールです。

豊富なアサーションメソッドを使うために、2.1.x系列のTest::Unitモジュールの導入がお勧めです。 → Test::Unit フレームワーク公式サイト

ファイル構造

今回はJabberクライアントの本体をとは別に単体テスト用のスクリプトを作成していて、次のように配置しています。

  • sendmsg.rb
  • ut/test_sendmsg.rb
  • lib/xmpp4r
  • lib/test

lib/testはgemsからインストールした後に gems/gems/test-unit-2.1.2/lib/test/ ディレクトリをコピーしています。

Jabberクライアント本体 スクリプト

sendmsg.rb スクリプトファイル

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-
$:.unshift File.join([File.dirname($0), "lib"])
require 'xmpp4r'

module YaJabber
  ## ステートレスなメソッド群
  def parse_options
  end
end

if $0 == __FILE__
  include YaJabber
  ## 処理本体が続く
end
単体テスト スクリプト

ut/test_sendmsg.rb スクリプトファイル

#!/usr/local/bin/ruby
# -*- coding: utf-8 -*-
$:.unshift File.join([File.dirname($0), "..", "lib"])
require 'test/unit'

class JabberClientTest < Test::Unit::TestCase
  $:.unshift File.join([File.dirname($0), ".."])
  require 'sendmsg'
  include YaJabber

  def test_parse_options
  end
end

抽象化できる部分は外部ライブラリの形でまとめるべきだとは思いますが、複数のファイルを管理するのはいろいろ面倒な場合もあります。

今回はそこまで難しくない単一のスクリプトファイルを相手にしつつ、Test::Unitを使ってみようとしている場面を想定しています。

規模が小さいとスクリプトをいくつかのシナリオの元で直接実行しても確認はできるので、こういう形式が必要なのか微妙なラインだとは思います。

ただ、こうやって単体スクリプトを作りつつ、他のスクリプトでも使えそうな共通部分があれば、自分用のモジュールライブラリを作れるかなぁ、とか思ってたりしてます。

外部ライブラリの読み込みについて

本当はxmpp4rライブラリやtest/unitライブラリはsite_rubyの中に入れているので、 $:変数を設定する必要はありませんでした。

ただ単体テスト用のスクリプトが"ut"サブディレクトリに入っていたので、スクリプト本体からの相対パスで設定している場合は、単体テストのスクリプトを実行した場合には相対パスの基準がut/サブディレクトリになってしまうため、$:変数を適切に設定する必要があることを忘れないために加えています。

2010/12/06

pdumpfsをruby 1.9.2-p0に対応させてみた

DTIのVPSサーバを契約してからバックアップを取るためにpdumpfsを使っています。 このために余計なパッケージは入れたくなかったので、自前で入れたruby-1.9.2-p0で動くようにpdumpfsを修正しました。

pdumpfsは ~/.gvfsでエラーになる対応の投稿のコードで、これをベースとしてruby 1.9.2-p0で動かしてみました。

オリジナルのライセンス

今回修正したpdumpfsは手元にあるものでおそらくpdumpfs-1.3だと思います。 ライセンスは以下のとおりで、もちろん私の修正もこのライセンスに準じます。

# Copyright (C) 2001-2004 Satoru Takabayashi <satoru@namazu.org>
#     All rights reserved.
#     This is free software with ABSOLUTELY NO WARRANTY.
#
# You can redistribute it and/or modify it under the terms of
# the GNU General Public License version 2.

パッチファイル

作成したファイルです。

大部分の方には上のdiffファイルが良いのだろうと思います。 offsetはかかりますが、手元では無事にpatchで修正できています。

以下に、また別の方法で作成したdiffを載せておきますが、これは私が~/.gvfsを無視するように修正したコードを含んでいます。

$ tar xvzf ~/pdumpfs-1.3.tar.gz
$ cd pdumpfs-1.3/
$ make
$ cp pdumpfs ../pdumpfs.orig
$ cd ..
$ diff -u pdumpfs.orig pdumpfs

コマンドの出力結果 (自分用)

--- pdumpfs.orig	2010-12-06 14:13:14.000000000 +0900
+++ pdumpfs	2010-12-06 14:12:47.000000000 +0900
@@ -1,4 +1,4 @@
-#! /usr/bin/env ruby
+#! /usr/local/bin/ruby
 #
 #  pdumpfs - a daily backup system similar to Plan9's dumpfs.
 #
@@ -48,21 +48,21 @@
 #
 
 require 'find'
-require 'ftools'
 require 'getoptlong'
 require 'date'
+require 'fileutils'
 
 class File
   def self.real_file? (path)
-    File.file?(path) and not File.symlink?(path)
+    FileTest.file?(path) and not FileTest.symlink?(path)
   end
 
   def self.anything_exist? (path)
-    File.exist?(path) or File.symlink?(path)
+    FileTest.exist?(path) or FileTest.symlink?(path)
   end
 
   def self.real_directory? (path)
-    File.directory?(path) and not File.symlink?(path)
+    FileTest.directory?(path) and not FileTest.symlink?(path)
   end
 
   def self.force_symlink (src, dest)
@@ -79,7 +79,7 @@
   end
 
   def self.readable_file? (path)
-    File.file?(path) and File.readable?(path)
+    FileTest.file?(path) and FileTest.readable?(path)
   end
 
   def self.split_all (path)
@@ -129,7 +129,7 @@
   GetVolumeInformation = Win32API.new("kernel32", "GetVolumeInformation",
                                       "PPLPPPPL", "I")
   def get_filesystem_type (path)
-    return nil unless(File.exist?(path))
+    return nil unless(FileTest.exist?(path))
 
     drive = File.expand_path(path)[0..2]
     buff = "\0" * 1024
@@ -807,12 +807,14 @@
     end
 
     def exclude? (path)
+      if @patterns.find {|pattern| pattern.match(path) }
+        return true
+      end
+      
       stat = File.lstat(path)
 
       if @size >= 0 and stat.file? and stat.size >= @size
         return true
-      elsif @patterns.find {|pattern| pattern.match(path) }
-        return true
       elsif stat.file? and
           @globs.find {|glob| File.fnmatch(glob, File.basename(path)) }
         return true
@@ -868,7 +870,7 @@
       today  = File.join(dest, datedir(start_time), base)
 
       File.umask(0077)
-      File.mkpath(today) unless @dry_run
+      FileUtils.mkpath(today) unless @dry_run
       if latest
         update_snapshot(src, latest, today)
       else
@@ -1018,7 +1020,7 @@
 
       case type
       when "directory"
-        File.mkpath(today)
+        FileUtils.mkpath(today)
       when "unchanged"
         File.force_link(latest, today)
       when "updated"
@@ -1052,7 +1054,7 @@
 
       Find.find(src) do |s|      # path of the source file
         if @matcher.exclude?(s)
-          if File.lstat(s).directory? then Find.prune() else next end
+          if FileTest.directory?(s) then Find.prune() else next end
         end
         r = make_relative_path(s, src)
         l = File.join(latest, r)  # path of the latest  snapshot
@@ -1089,7 +1091,7 @@
 
           case type
           when "directory"
-            File.mkpath(t)
+            FileUtils.mkpath(t)
           when "new_file"
             copy(s, t)
           when "symlink"

これは自分が後から別のデスクトップ環境を使う時のための保存用ですが、似たような問題があれば使ってください。

2010/11/30

CouchDB: Ruby CouchモジュールをDigest認証対応にする

CouchDBのGetting startedには Ruby用のCouchモジュールが掲載されています。

Basic認証に対応させたり、SSLクライアント認証対応にしたりしてきましたが、今回はDigest認証に対応させる事にしました。

これはCouchDBの標準機能ではありません。フロントエンドにApacheなどでProxy Serverを配置し、そのProxy ServerがDigest認証を行なう事を想定しています。

なおDigest認証の仕様は RFC2069 - An Extension to HTTP : Digest Access Authenticationで定義されています。

使い方のサンプル

Couch::Server#newメソッドの第三引数のハッシュに'digest_auth'プロパティを設定します。 他はBasic認証と同じです。

サンプルコード

couch =  Couch::Server.new("couch.example.org","443", {
                           'digest_auth' => 'true',
		           'user' => 'admin',
		           'password' => 'xxxxxxxxxxxx',
		         ...})

他は同じように使えますが、ループの中で繰り返し実行するような場合には#get, #post, #put, #deleteなどの各メソッドで再認証を求められる可能性を考慮する必要があります。

open(file).each_line do |line|
  row = 
  json = Hash.new
  ...
  res = ""
  while not res.kind_of?(Net::HTTPSuccess)
    begin
      res = couch.post(uri, json.to_json)
    rescue
      p $!
    end
  end
end

ライブラリを少し変更すると自動的に再認証することもできますが、最大回数を設定するなどの配慮が必要になるでしょう。

Digest情報のキャッシュ

今回利用したライブラリのサンプルでは再利用の方法について、サンプルはないようでした。

RFC2069では、再利用できる情報としてusername, password, nonce, nonce count and opaque valuesが挙げられています。

これらの情報を使いまわすようにしていますが、手元のApacheを使った環境では5分毎に再認証(rc=401)を求められます。

この挙動への対応として、ライブラリ側でのコントロールをしない方法を選択しました。 オリジナルのライブラリで行なっていたレスポンスコードに応じた例外の送出は行なわれません。

レスポンスオブジェクトはそのままクライアントに返すので、クライアント側では再認証が発生した場合に再度メソッドを呼び出すなど判断をしてください。

net-http-digest_authモジュールの導入

標準ライブラリではDigest認証に対応しません。今回は net-http-digest_authを利用しました。

このライブラリのロードはdigest_authプロパティを設定した場合に発生するので、クライアント側でrubygemsを呼び出すなどの準備が必要です。

couchdb.rbと同じディレクトリにnetディレクトリを配置した場合の設定例

main.rbからcouchdb.rbを呼び出す、次のようなディレクトリ構造を想定しています。

bin/main.rb
lib/
lib/couchdb.rb
lib/net/http/digest_auth.rb

main.rbでは次のようにライブラリをロードします。

netディレクトリを手動で配置した場合の設定例

$:.unshift File.join([File.dirname($0),"..","lib"])
require 'couchdb'
gemsを使う場合の設定例

今回もmain.rbからcouchdb.rbを呼び出す、次のようなディレクトリ構造を想定しています。

$ cd lib
$ gem install -i gems net-http-digest_auth
bin/main.rb
lib/couchdb.rb
lib/gems/gems/net-http-digest_auth-1.0/lib/net/http/digest_auth.rb

標準以外の場所にgemsディレクトリがある場合の対応は以下のようになります。 (-iオプションを使わずに)標準的な場所にインストールした場合には、当然、ENV['GEM_HOME']の行は不要です。

gemsを使う場合の設定例

ENV['GEM_HOME'] = File.join([File.dirname($0),"..","lib","gems"])
require 'rubygems'
$:.unshift File.join([File.dirname($0),"..","lib"])
require 'couchdb'

変更を加えたCouchモジュール

モジュールの全体は次の通りです。

変更したCouchモジュール: lib/couchdb.rb

# -*- coding: utf-8 -*-

require 'net/https'

#
# This module comes from the couchdb wiki;
# http://wiki.apache.org/couchdb/Getting_started_with_Ruby
#
# Modifyed by Yasuhiro ABE - yasu@yasundial.org
#
module Couch

  class Server
    def initialize(host, port, options = nil)
      @host = host
      @port = port
      @options = options
      @options = Hash.new if options.nil? or not options.kind_of?(Hash)
      @www_auth = nil
      @auth = nil
      if options.has_key?('digest_auth')
        require 'net/http/digest_auth'
        @digest_auth = Net::HTTP::DigestAuth.new
      end
    end

    def delete(uri)
      setup_digest_auth(uri,'DELETE')
      request(Net::HTTP::Delete.new(uri))
    end

    def get(uri)
      setup_digest_auth(uri,'GET')
      request(Net::HTTP::Get.new(uri))
    end

    def put(uri, json)
      setup_digest_auth(uri,'PUT')
      req = Net::HTTP::Put.new(uri)
      req["content-type"] = "application/json"
      req.body = json
      request(req)
    end

    def post(uri, json)
      setup_digest_auth(uri,'POST')
      req = Net::HTTP::Post.new(uri)
      req["content-type"] = "application/json"
      req.body = json
      request(req)
    end

    def check_ssl(client)
      if @options.has_key?('cacert')
        client.use_ssl = true
        client.ca_file = @options['cacert']
        client.verify_mode  = @options['ssl_verify_mode'] if @options.has_key?('ssl_verify_mode')
        client.verify_mode  = OpenSSL::SSL::VERIFY_PEER if not @options.has_key?('ssl_verify_mode')
        client.verify_depth = @options['ssl_verify_depth'] if @options.has_key?('ssl_verify_depth')
        client.verify_depth = 5 if not @options.has_key?('ssl_verify_depth')
        client.cert         = @options['ssl_client_cert'] if @options.has_key?('ssl_client_cert')
        client.key          = @options['ssl_client_key'] if @options.has_key?('ssl_client_key')
      end
    end

    def request(req)
      req.basic_auth @options['user'], @options['password'] if @options.has_key?('user') and @options.has_key?('password') and not @options.has_key?('digest_auth')
      req["X-Auth-CouchDB-UserName"] = @options['proxy_auth_user'] if @options.has_key?('proxy_auth_user')
      req["X-Auth-CouchDB-Roles"] = @options['proxy_auth_roles'] if @options.has_key?('proxy_auth_roles')
      req["X-Auth-CouchDB-Token"] = @options['proxy_auth_token'] if @options.has_key?('proxy_auth_token')
      
      client = Net::HTTP.new(@host, @port)
      check_ssl(client)
      
      if @options.has_key?('digest_auth')
        req["Authorization"] = @auth
      end
      
      res = client.start { |http| http.request(req) }
      @www_auth = nil if res.kind_of?(Net::HTTPUnauthorized) and @options.has_key?('digest_auth')
      res
    end
    
    private

    def setup_digest_auth(uri, method)
      return if not @options.has_key?('digest_auth')
      if @www_auth == nil
        req = Net::HTTP::Get.new(uri)
        client = Net::HTTP.new(@host, @port)
        check_ssl(client)
        res = client.start { |http| http.request(req) }
        ## res must be the Net::HTTPUnauthorized
        raise res if not res.kind_of?(Net::HTTPUnauthorized)
        @www_auth = res['www-authenticate']
      end
      url = TinyURI.new(@options['user'], @options['password'], uri)
      @auth = @digest_auth.auth_header(url, @www_auth, method)
    end
  end

  private
  # net/http/digest_auth using this class to pass information.
  class TinyURI  # :nodoc:all
    attr_accessor :request_uri, :user, :password
    def initialize(user, pass, path)
      @user = user 
      @password = pass
      @request_uri = path
    end
  end
end

2010/11/30 22:00追記
認証に失敗した場合に@www_authを初期化するコードが抜けていたので追記しています。

モジュールの使い方: README.rd

手元で書いたREADME.rbの内容をそのまま転載します。

ruby用Couchモジュールについて

http://wiki.apache.org/couchdb/Getting_started_with_Ruby に掲載されているモジュールをベースにしています。

追加した機能は次の通りです。

  • Proxy認証 (couch_httpd_auth:proxy_authentification_handler用)
  • SSLクライアント認証 (stunnelを想定したセキュア接続用)
  • Basic認証 (couch_httpd_auth:default_authentication_handler, apache等proxy serverでの認証用)
  • Digest認証 (apache等proxy serverでの認証用)

基本的な使い方はCouch::Server.new(host,port,options)でインスタンス生成時のoptions引数にハッシュを与えます。

プロパティ認証用プロパティ

optionsにプロパティが設定されていない場合には何もしません。 値がセットされている場合に、各ヘッダにその値を指定します。

  • proxy_auth_user (X-Auth-CouchDB-UserNameヘッダの値にセット)
  • proxy_auth_roles (X-Auth-CouchDB-Rolesヘッダの値にセット)
  • proxy_auth_token (X-Auth-CouchDB-Tokenヘッダの値にセット)

現状ではこれらの値の設定をサポートするメソッドは提供されません。

Basic and Digest認証用プロパティ

認証を有効にするためには、user, password両方とも設定する必要があります。

  • user (任意の文字列)
  • password (任意の文字列)
Digest認証用プロパティ

次の"digest_auth"が設定され、@options.has_key?('digest_auth')がtrueを返す場合に有効です。

  • digest_auth (設定されている場合に有効)

この機能のテストでは{ "digest_auth" => "true" } のようにダミーの文字列を設定しています。

Digest認証を使うクライアントで必要なライブラリのロード

Digest認証を有効にした場合には、net/http/digest_auth モジュールをロードしようとします。

デフォルトでは有効になっていないので、モジュールを適切な方法で配置してください。

方法の1つは次のようにcouchdb.rbと同じディレクトリにnetディレクトリを配置して、相対パスでこのlibディレクトリを$:変数に含める方法です。


  bin/main.rb
  lib/
  lib/couchdb.rb
  lib/net/http/digest_auth.rb

main.rbには次のように記述します。

  $:.unshift File.join([File.dirname($0),"..","lib"])
  require 'couchdb'

方法の2つめはgemsを使い、require 'rubygems'を加える方法です。 デフォルトの場所以外にgemsでインストールした場合には次のように、その場所をポイントする必要があります。

$ gem install -i gems net-http-digest_auth

次のようなディレクトリ構造だとします。


  bin/main.rb
  lib/couchdb.rb
  lib/gems/gems/net-http-digest_auth-1.0/lib/net/http/digest_auth.rb

この場合は、main.rbの先頭は次のようになるでしょう。

  ENV['GEM_HOME'] = File.join([File.dirname($0),"..","lib","gems"])
  require 'rubygems'
  $:.unshift File.join([File.dirname($0),"..","lib"])
  require 'couchdb'

前者の方法はシンプルですがライブラリのメンテナンスを考えるならgemsの利用も検討するべきです。

それにドメイン毎の事情を考慮して、他の方法を検討することはとても素晴しいアプローチです。

SSLクライアント認証用プロパティ

stunnelを使って検証しています。

cacertが設定されている場合に、自動的にNet::HTTP#use_sslを有効にします。 それぞれに設定する値の詳細は、net/httpsのNet::HTTPクラスライブラリを参照してください。

  • cacert (デフォルト値なし。pemファイルへのパス文字列)
  • ssl_verify_mode (default: OpenSSL::SSL::VERIFY_PEER。another value: OpenSSL::SSL::VERIFY_NONE)
  • ssl_verify_depth (default: 5)
  • ssl_client_cert (default値なし。OpenSSL::X509::Certificate オブジェクト)
  • ssl_client_key (default値なし。OpenSSL::PKey::RSA オブジェクト、もしくは、OpenSSL::PKey::DSA オブジェクト)
SSLクライアント認証とBasic認証を組み合せる場合のコーディング例

n少なくとも次のような方法で各オブジェクトを準備し、Couch::Serverクラスのインスタンスを生成する事が必要です。 Basic認証が不要な場合は、user, passwordプロパティを設定しないでください。

詳細はnet/httpsのNet::HTTPクラスライブラリの各メソッドから、OpenSSL:SSLクラスライブラリと併せて参照してください。

  ssl_client_cert = OpenSSL::X509::Certificate.new(File.new(File.expand_path('stunnel.client.cert.pem', File.dirname($0))))
  ssl_client_key = OpenSSL::PKey::RSA.new(File.new(File.expand_path('stunnel.client.key.pem', File.dirname($0))), 'xxxxxxx')

  couch = Couch::Server.new("couch.example.org","5984", {
    'user' => 'admin',
    'password' => 'xxxxxxxxxx',
    'cacert' => File.expand_path('cacert.pem', File.dirname($0)),
    'ssl_client_cert' => ssl_client_cert,
    'ssl_client_key'  => ssl_client_key
  })
SSLサーバ認証について

SSLサーバ認証は、SSLクライアント認証のサブセットで、少なくともcacertプロパティにはサーバ側の証明書が検証できるPEMファイルを設定することが必要です。

その他のプロパティは任意です。

2010/11/11

CouchDBをデスクトップ用DBとして使う場合のセキュリティ上の懸念点

CouchDBはデフォルトで 127.0.0.1:5984にバインドするようになってはいますが、ローカルユーザに対するセキュリティはデフォルトでは何もありません。 loopback IPアドレスへのバインドがセキュリティだなんていわないですよね…。

デスクトップ用のDBを探しているとはいえ、Linuxは元々マルチユーザOSですし、それでなくてもいろいろ心配です。

認証(Authentication)はCouchDB全体で一つで良いですが、できれば認証はLDAPと連携したいし、承認(Authorization)はDB毎に行ないたいところです。FAQをみるとDocument毎の承認は無理みたいですね…。

たまたま CouchDBのCookie認証についての記事をみつけたので参考にしつつ、どういうシステムなのか実際に設定を変更して確認してみました。

準備作業

source codeを確認する必要がありそうなので、apt-get source couchdbと最新の apache-couchdb-1.0.1.tar.gzを展開しました。

またUbuntu上の0.10.0でも確認するようにしていますが、基本的には最新の1.0.1をmake installして確認作業をしています。

Basic認証 - 普通のWebサーバレベル

参考にさせて頂いたyssk22さんの記事だと「local.iniにユーザ名とパスワードの組を書いておく」べし、となっています。

どういう事なのかなと思ってlocal.iniファイルをみると、次のような変更が必要でした。

変更前のlocal.iniファイル抜粋

...
;WWW-Authenticate = Basic realm="administrator"
...
; require_valid_user = false
...
[admins]
;admin = mysecretpassword

変更後のlocal.iniファイル抜粋

...
WWW-Authenticate = Basic realm="administrator"
...
require_valid_user = true
...
[admins]
;admin = mysecretpassword
user1 = ab5e29d1

この設定でBasic認証が要求されるようになりましたが、少し問題もありました。

最初の問題は、local.ini に書いた生のパスワードは次のようにハッシュ化した状態で書き換えられるため、local.ini ファイルに書き込み権限がないと起動に失敗します。

user1 = -hashed-2f8dfa38b8543afaf3675d62f46c575bc96e7972,2ae6fb964a7f37818a1db077bbfc1def

これはパスワードをじかに書いた後の一度だけなので、起動してしまえば書き込み権限は不要です。

それも避けたいという場合には、直接この行を生成することもできます。

カンマで区切られた後半の文字列はSaltですから、次のようにすれば手動で生成できます。 パスワードやSaltを適宜変更することを忘れないでください。

$ echo -n "ab5e29d1""2ae6fb964a7f37818a1db077bbfc1def" | sha1sum
2f8dfa38b8543afaf3675d62f46c575bc96e7972  -

次の問題はUbuntuのパッケージから導入したり、make installすると、local.iniのファイルパーミッションが644になるところです。 CouchDB WikiのInstalling on Ubuntuでは、次のようなパーミッションを設定しています。

chown -R root:couchdb /etc/couchdb
chmod 664 /etc/couchdb/*.ini
chmod 775 /etc/couchdb/*.d

これが悪いとはいわないけれど、ガイドの記述に追加して、Otherに対するアクセス権を落しています。

$ sudo chmod 2750 /etc/couchdb
$ sudo chmod o-rwx /etc/couchdb/local.ini

Makefile.amにchmod o-rwxを入れる事もできるけれど、どういうパーミッションにするのかはサイトのポリシーの問題でもあります。 少なくともやたらと書き込み権限を落すと起動しなくなる場合があることには注意が必要でしょう。

残りはRuby用のCouchモジュールで、Basic認証の機能がないので元々準備されていた@optionsインスタンス変数を利用して、ID/Passwordを与えるように修正しました。

Couchモジュール(couchdb.rb)の変更個所

--- couchdb.rb.orig	2010-11-09 19:27:38.000000000 +0900
+++ couchdb.rb	2010-11-09 19:27:31.000000000 +0900
@@ -32,6 +32,7 @@
     end
 
     def request(req)
+      req.basic_auth @options['user'], @options['password'] if @options.kind_of?(Hash) and @options.has_key?('user') and @options.has_key?('password')
       res = Net::HTTP.start(@host, @port) { |http|http.request(req) }
       unless res.kind_of?(Net::HTTPSuccess)
         handle_error(req, res)

クライアント側コードにIDとパスワード設定を追加

--- main.rb.orig	2010-11-09 19:17:53.000000000 +0900
+++ main.rb	2010-11-09 19:18:27.000000000 +0900
@@ -9,7 +9,7 @@
 
 csv = GenCSVText.new
 
-couch = Couch::Server.new("172.16.73.197","5984")
+couch = Couch::Server.new("172.16.73.197","5984",{'user'=>'user1', 'password'=>'ab5e29d1'})
 1000.times do |doc_id|
   doc_url = "/csv/qa." + doc_id.to_s
   res = nil

Basic認証については、こんなところです。

認証方式の設定について

couchdbでの認証方法の種類を設定する方法や、その仕組みについてまとめておきます。

まずは default.ini ファイルに書かれている authentication_handlers について。

authentication_handlers = {couch_httpd_oauth, oauth_authentication_handler},
                                {couch_httpd_auth, cookie_authentication_handler},
                                {couch_httpd_auth, default_authentication_handler}

右辺にあるタプルの前半はモジュール名で、src/couchdb/couch_httpd_auth.erl などにある関数を、2番目の *_handler で指定しています。

default_authentication_handler が実際に使われる主な処理をしているところだと思います。

使える候補としては、couch_httpd_auth.erlで-export()で宣言されている関数は次の通りです。

-export([default_authentication_handler/1,special_test_authentication_handler/1]).
-export([cookie_authentication_handler/1]).
-export([null_authentication_handler/1]).
-export([proxy_authentification_handler/1]).
-export([cookie_auth_header/2]).

yssk22さんの説明は助かっていますが、残念ながらCookie認証についてはほとんど理解できていません。 Cookie認証は少し放っておいて、コメントのある proxy_authentification_handler を試すことにしました。

proxy_authentification_handler について

Ubuntu 10.04 LTSのパッケージで導入している0.10.0では、 proxy_authentification_handlerはありません。 CHANGESファイルによれば、0.11.0から導入されたようです。 ここから先は手動でVMWare上のUbuntu 10.04に導入した、1.0.1で試しています。

この proxy_authentification_handler はコメントを読むと、認証を他のシステムで行なった結果を送ってもらい、couchdbとその認証システムで共有しているtokenをキーに生成した情報を照合するという仕組みのようです。

Cookieのような時間制限をどうやって行なっているんだろうと思いつつ、試してみることにします。

proxy_authentification_handler の設定

クライアントはどうにかして、HTTPヘッダにいくつかのパラメータを設定します。

  • X-Auth-CouchDB-UserName - 'admin'や'user1'といったBasic認証と同じようなID名
  • X-Auth-CouchDB-Roles - Basic認証でいうところの'admin'です
  • X-Auth-CouchDB-Token - secret と X-Auth-CouchDB-UserNameを連結した文字列のSHA1 Message Digest

対応するlocal.iniの[couch_httpd_auth]に設定するパラメータは次のとおりです。

  • (必須)proxy_use_secret - "true"の時にX-Auth-CouchDB-Tokenの照合を行ない、それ以外の値であれば無条件にX-Auth-CouchDB-UserNameのUser名とX-Auth-CouchDB-Rolesのロールを設定
  • (必須)secret - X-Auth-CouchDB-Tokenを生成に使う文字列
  • x_auth_username - X-Auth-CouchDB-UserNameの別名を定義
  • x_auth_roles - X-Auth-CouchDB-Rolesの別名を定義
  • x_auth_token - X-Auth-CouchDB-Tokenの別名を定義
サーバ側の設定作業

まずは default.ini に、proxy_authentification_handler を設定します。

default.iniファイルの該当行の抜粋

authentication_handlers = {couch_httpd_auth, proxy_authentification_handler}

次に local.ini に、必須な2つのフィールドを追加します。

proxy_authだけを有効にする場合のcouch_httpd_authセクション

[couch_httpd_auth]
secret = 329435e5e66be809a656af105f42401e
proxy_use_secret = true

これで一応はサーバ側の準備はできましたが、問題はクライアントの準備です。

クライアント側の設定作業

さきほどのcouchdb.rbにさらに変更を加えることにしました。

couchdb.rb変更部分のdiff

--- couchdb.rb.orig	2010-11-10 20:44:14.000000000 +0900
+++ couchdb.rb	2010-11-10 20:45:04.000000000 +0900
@@ -33,6 +33,9 @@
 
     def request(req)
       req.basic_auth @options['user'], @options['password'] if @options.kind_of?(Hash) and @options.has_key?('user') and @options.has_key?('password')
+      req["X-Auth-CouchDB-UserName"] = @options['proxy_auth_user'] if @options.kind_of?(Hash) and @options.has_key?('proxy_auth_user')
+      req["X-Auth-CouchDB-Roles"] = @options['proxy_auth_roles'] if @options.kind_of?(Hash) and @options.has_key?('proxy_auth_roles')
+      req["X-Auth-CouchDB-Token"] = @options['proxy_auth_token'] if @options.kind_of?(Hash) and @options.has_key?('proxy_auth_token')
       res = Net::HTTP.start(@host, @port) { |http|http.request(req) }
       unless res.kind_of?(Net::HTTPSuccess)
         handle_error(req, res)

main.rb変更部分のdiff

--- main.rb.orig	2010-11-10 20:43:54.000000000 +0900
+++ main.rb	2010-11-10 20:27:55.000000000 +0900
@@ -8,7 +8,9 @@
 require 'json'
 
 csv = GenCSVText.new
-couch = Couch::Server.new("127.0.0.1","5984",{'user'=>'user1', 'password'=>'ab5e29d1'})
+couch = Couch::Server.new("127.0.0.1","5984",{'user'=>'user1', 'password'=>'ab5e29d1',
+		:proxy_auth_user => "user1", :proxy_auth_roles => "_admin,_users",
+		:proxy_auth_token => "d4c3b0fd10bed9642fb5bbfcc0203ca27c707300" })
 10.times do |doc_id|
   doc_url = "/csv/qa." + doc_id.to_s
   res = nil

実際に使う段階になると、 proxy_auth_token の生成方法をどうしようかなと思いました。

erlを使って文字列を生成する方法は次のようになります。

couch_util.erl か couch_util.beam のあるディレクトリ(今回は ~/apache-couchdb-1.0.1/src/couchdb/)をpathに追加するため、 -paオプションに渡しています。 ファイルが存在すれば、/usr/lib/couchdb/erlang/lib/couch-0.10.0/ebin などでも構いません。

$ erl -pa ~/apache-couchdb-1.0.1/src/couchdb/
1> nl(couch_util).
2> nl(crypto).
3> crypto:start().
4> D = <<"user1">>.
5> KK = <<"329435e5e66be809a656af105f42401e">>.
6> couch_util:to_hex(crypto:sha_mac(KK,D)).

最後のコマンドを入力すると、この場合は "d4c3b0fd10bed9642fb5bbfcc0203ca27c707300" になります。

改造したcouchdb.rbを利用するmain.rbの全体は、次のようになっています。

CouchDB独自のProxy認証を行なうmain.rb全体

#!/usr/local/bin/ruby1.9 -I.
# -*- encoding: UTF-8 -*-

$:.unshift File.dirname($0)

require 'couchdb'
require 'json'

couch = Couch::Server.new("127.0.0.1","5984",{:proxy_auth_user => "user1", 
                :proxy_auth_roles => "_admin",
		:proxy_auth_token => "d4c3b0fd10bed9642fb5bbfcc0203ca27c707300" })

res = couch.get("/_all_dbs")
p JSON.parse(res.body)

2010/11/17追記:
このスクリプトとcouchdb.rbは同じディレクトリにあると仮定しています。
couchdb.rbがカレントディレクトリにない場所からパスを指定してスクリプトを起動した場合に、動かないため$:.unshift "."だった記述を修正しました。

パスワードに相当する情報はtokenに何も反映されませんから、MACの強度にだけ依存しています。 せめてMACに与えるSecretにtoken以外のユーザ毎に変化する何かも加えられれば良かったんですけどね。

全体で一つのtokenに依存していますから、頻繁にtokenを入れ替えない限りはちょっと使いたくない感じのものだという事はわかりました。

ちなみに、WebブラウザのProxyに指定してX-CouchDB-Auth-*ヘッダを追加するProxyサーバのコードも載せておきます。

手元のテンプレートを元に作成したProxyサーバ

#!/usr/bin/ruby

require "socket"
require "uri"

gs = TCPServer.open("localhost", 8880)
while TRUE
  Thread.start(gs.accept) do |s|
    ## prepare and modify request header part
    remote = nil
    begin
      h = Array.new
      while (l = s.gets)
        break if l =~ /^\r\n|^\n/
        if l =~ /^Keep-Alive:/
          ## ignore the keep-alive header
        elsif l =~ /Proxy-Connection:/
          ## remove the proxy-connection header because of no keep-alive support.
          h << "Connection: close\r\n"
        elsif l =~ /Auth/
          p l
        elsif l =~ /^Cookie/
          p l
        else
          h << l
        end
      end
      h << "X-Auth-CouchDB-UserName: user1\r\n"
      h << "X-Auth-CouchDB-Roles: _admin\r\n"
      h << "X-Auth-CouchDB-Token: d4c3b0fd10bed9642fb5bbfcc0203ca27c707300\r\n"
      h << "\r\n"

      ## override first line of header
      hp, huri, hv = h[0].split(/\s+/)
      raise "wrong request header" if hp.nil? or hv.nil?
      uri = URI.parse(huri)
      p huri
      h[0] = "#{hp} #{uri.path} #{hv}\r\n"

      ## open endpoint
      remote = TCPSocket.open(uri.host, uri.port)
      ## send header info
      h.each {|i|
        remote.puts i
      }
      
      ## get response
      while(l = remote.gets)
        s.puts l
        break if l =~ /^\r\n|^\n/
      end

      ## get body
      while (l = remote.gets)
        s.puts l
      end
    ensure
      remote.close
      s.close
    end
  end
end

このスクリプトを走らせた後に、WebブラウザのProxy設定で ホスト名"127.0.0.1", ポート番号"8880"を指定してアクセスすればCouchDBのWebフロントエンド Futon にアクセスできます。

このProxyを経由して他のサーバにアクセスに行くと、余計な認証情報をばらまく事になるので、URIの解析を始めに行なってh << "X-Auth-CouchDB-UserName: user1\r\n" if uri.port == "5984"ぐらいしておくと安心かもしれません。

proxy_authentification_handler を使った感想

X-Auth-CouchDB-*のヘッダを付与しないリクエストを送信する一般ユーザでもDBの参照は可能なままです。

これは handler のコードが次のようになっていて、実際の処理を行なうproxy_auth_user関数がnilを返した時には拒否をせずに現状のReqコンテキストを返すことに起因しているようです。

couch_httpd_auth.erlのhandler関数全体

proxy_authentification_handler(Req) ->
    case proxy_auth_user(Req) of
        nil -> Req;
        Req2 -> Req2
    end.

Proxyを経由しないアクセスを拒否するのであれば、Reqを返さずにnil -> throw({unauthorized, <<"token is incorrect.">>});;ぐらいにすると、{"error":"unauthorized","reason":"token is incorrect."} という返答が返るようになります。

cookie_authentication_handlerは良さそうだけれど、とりあえずは default_authentication_handler を設定して、proxy_authentification_handler が失敗した場合でもBasic認証がかかるようにしておきました。

次は cookie_authentication_handler について、 Secure Cookie Authentication for CouchDBをまずは読んでみようとしています。

ファイルレベルのパーミッションについて

ファイルのパーミッションは、個々の作業の中でもいろいろ出てきたので、まとめておきたいと思います。

とりあえずUbuntuで標準的に導入されるパッケージの設定では/var/lib/couchdbのディレクトリレベルでパーミッションを0750になっています。

認証を行なう場合は default.ini や local.ini あるいは、DB自体に何らかの情報を含む可能性があるので、それらのディレクトリの所有者/グループを root:couchdb に変更し、サーバが書き込む必要のないところは、g-wX,o-rwX、必要なところは g+wX,o-rwX ぐらいをchmodで設定するのがベストです。

ただ、それでも新規に作成されるDBなどのファイルは644で、バックアップファイルの扱いなど懸念があります。 起動スクリプトに'.'で読み込まれる /etc/default/couchdb にumask 027の一行を加えておきました。

Ubuntu 10.04 LTSで使っているCouchDB用には、次のような設定をしています。

$ sudo chmod -R o-rwX /var/lib/couchdb
$ sudo chmod g+s /var/lib/couchdb /var/lib/couchdb/0.10.0
$ sudo chown -R root:couchdb /etc/couchdb
$ sudo chmod -R g-w,g+rX,o-rwX /etc/couchdb
$ sudo chmod g+s /etc/couchdb
$ echo umask 027 | sudo tee -a /etc/default/couchdb

default.ini, local.ini をcouchdbプロセスが書き込めるようにするかは、必要性とポリシー次第かなと思います。

Linuxなら /etc/login.defs 辺りで、UMASK 027 を設定するべきかなとも思います。

まとめ

微妙に綴りの違う、*_authentication_handler と proxy_authenti fication_handler がまぎらわしい。

CouchDBは良さそうだけど、エラーメッセージ系はもうちょっと改善してほしいところ。

冗談ではないけれど、もう少しまじめに書くと、cookie認証にあるようなtimestampの概念はProxy認証では導入されていませんでした。 これは必要じゃないかなと感じてcookie認証についてのドキュメントとコードを読み始めています。

Proxy認証は自分で認証モジュールを作りたい場合の雛型コードとしてはシンプルで良いけれど、実用的なものではなさそうだというのが今のところの印象です。

経緯を調べてみたんですが、みつけられなかったんですよね。